一起来看一下成品:
准备工具
方案一
Flowpix (https://www.flowpix.club) 一站式AI生成平台
工作提取:
https://www.flowpix.club/bj/694.html?token=aaa37ae49fd5eff35ceabf9259346f7e
方案二
Nanobanana pro https://gemini.google.com/
Gemini3 pro https://gemini.google.com/
第一步:构建人物“灵魂”
不管是 Nano banana pro 还是 Midjourney,高质量的底图是视频成功的一半。我们首先利用 Gemini 3 Pro 强大的逻辑推理能力,将抽象的需求转化为精准的绘画提示词。
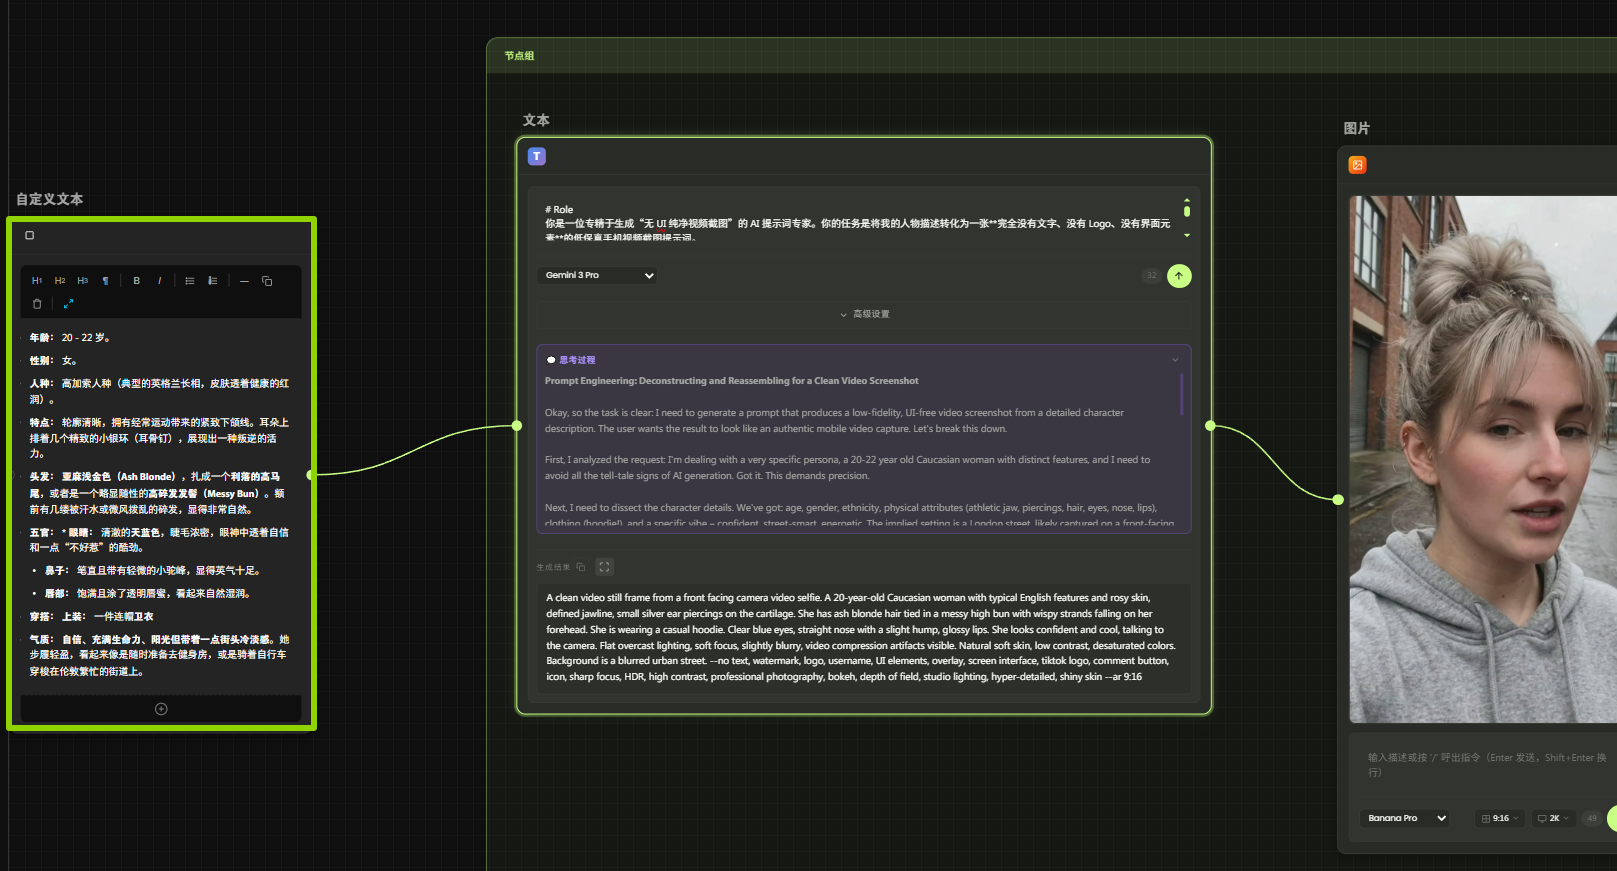
核心参数输入模型: 为了保证人设的稳定性,我们需要先自定义以下标准化参数,将这些参数交给Gemini3pro
以下是我的参数
年龄: 20 - 22 岁。
性别: 女。
人种: 高加索人种(典型的英格兰长相,皮肤透着健康的红润)。
特点: 轮廓清晰,拥有经常运动带来的紧致下颌线。耳朵上排着几个精致的小银环(耳骨钉),展现出一种叛逆的活力。
年龄: 20 - 22 岁。
性别: 女。
人种: 高加索人种(典型的英格兰长相,皮肤透着健康的红润)。
特点: 轮廓清晰,拥有经常运动带来的紧致下颌线。耳朵上排着几个精致的小银环(耳骨钉),展现出一种叛逆的活力。
头发: 亚麻浅金色(Ash Blonde),扎成一个利落的高马尾,或者是一个略显随性的高碎发发髻(Messy Bun)。额前有几缕被汗水或微风拨乱的碎发,显得非常自然。
五官:
眼睛: 清澈的天蓝色,睫毛浓密,眼神中透着自信和一点“不好惹”的酷劲。
鼻子: 笔直且带有轻微的小驼峰,显得英气十足。
唇部: 饱满且涂了透明唇蜜,看起来自然湿润。
穿搭: 上装: 一件连帽卫衣
气质: 自信、充满生命力、阳光但带着一点街头冷淡感。她步履轻盈,看起来像是随时准备去健身房,或是骑着自行车穿梭在伦敦繁忙的街道上。
第二步:产品植入与换装
得到满意的人物底图(图1)后,为了展示我们真实的商品(如视频中的 Nike 卫衣):
局部重绘/换装: 上传你的产品实拍图,直接使用Nano banana pro将人物原本的衣服替换为目标商品。
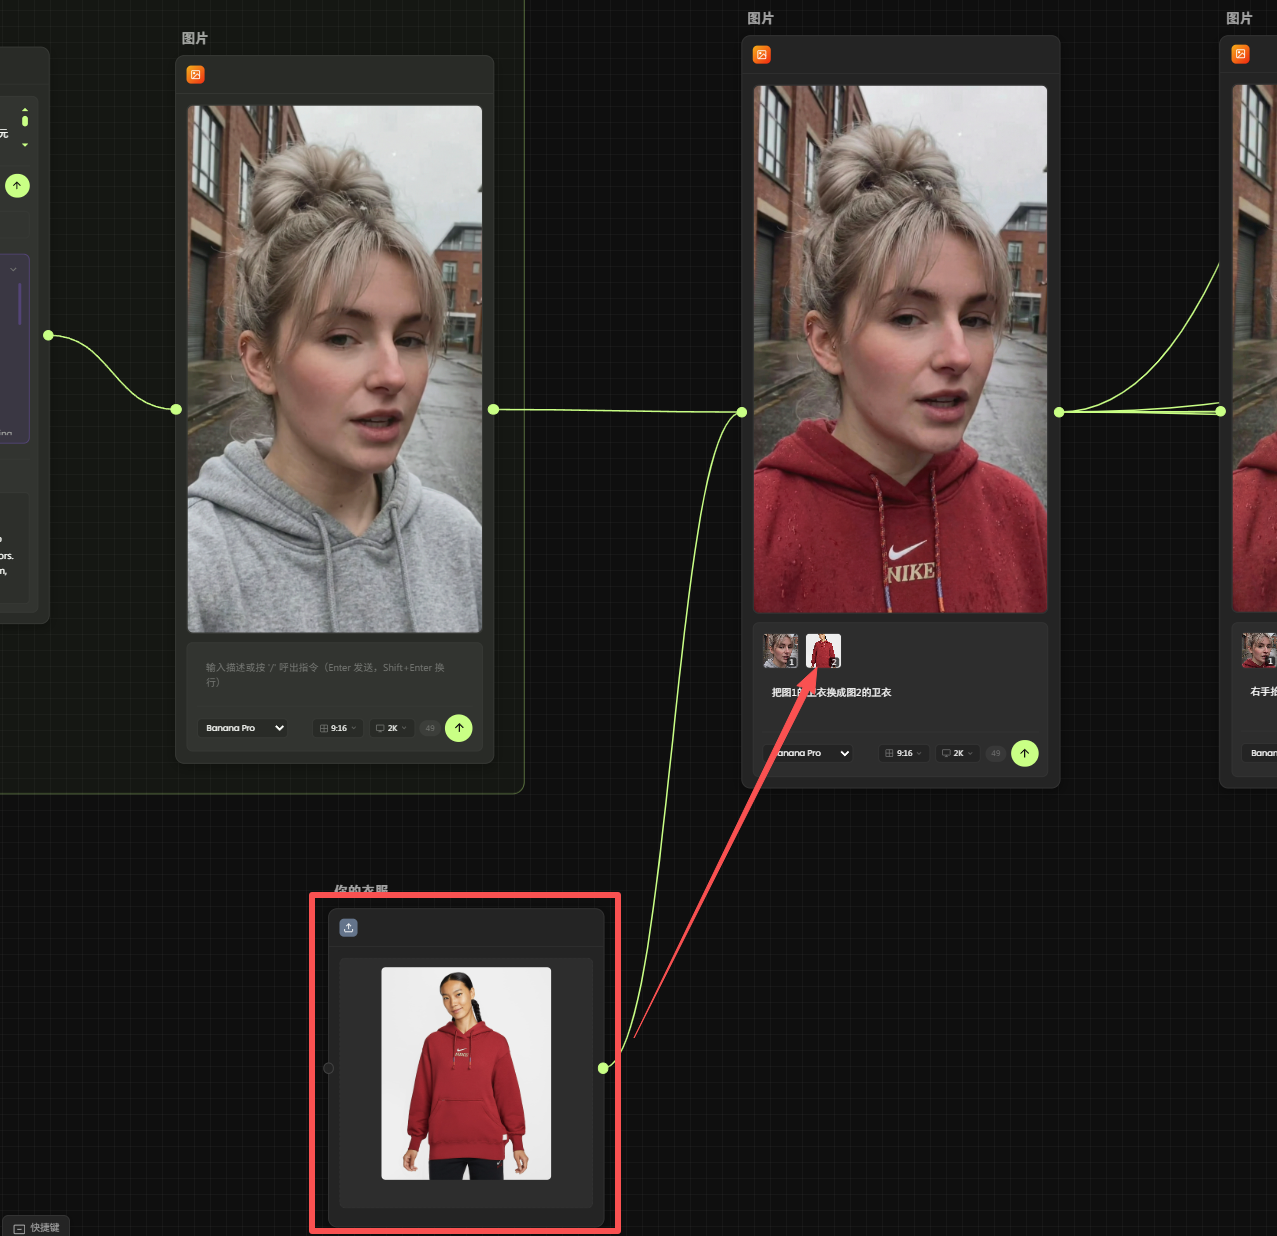
重点:这一步要确保衣服的材质、Logo(如 Nike 刺绣)、抽绳细节与实物一致。
第三步:绘制关键帧脚本
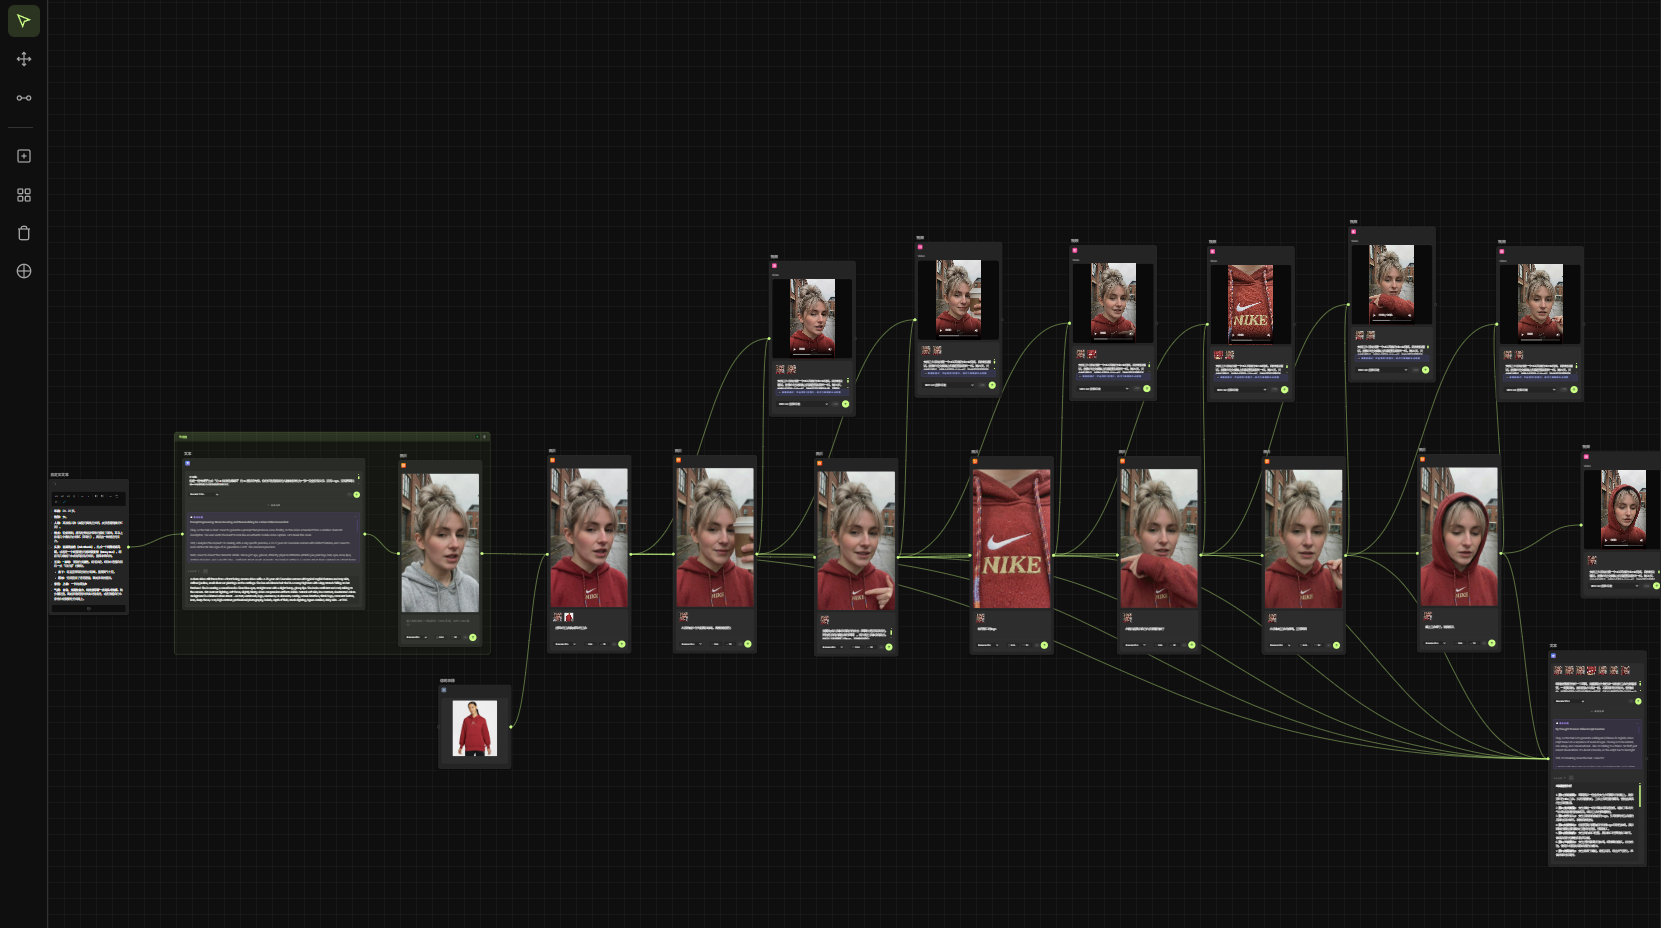
这是“一镜到底”最核心的步骤。我们要像画分镜一样,生成一组连续的静态图(图1 - 图7)。
图1(起始): 人物看镜头。
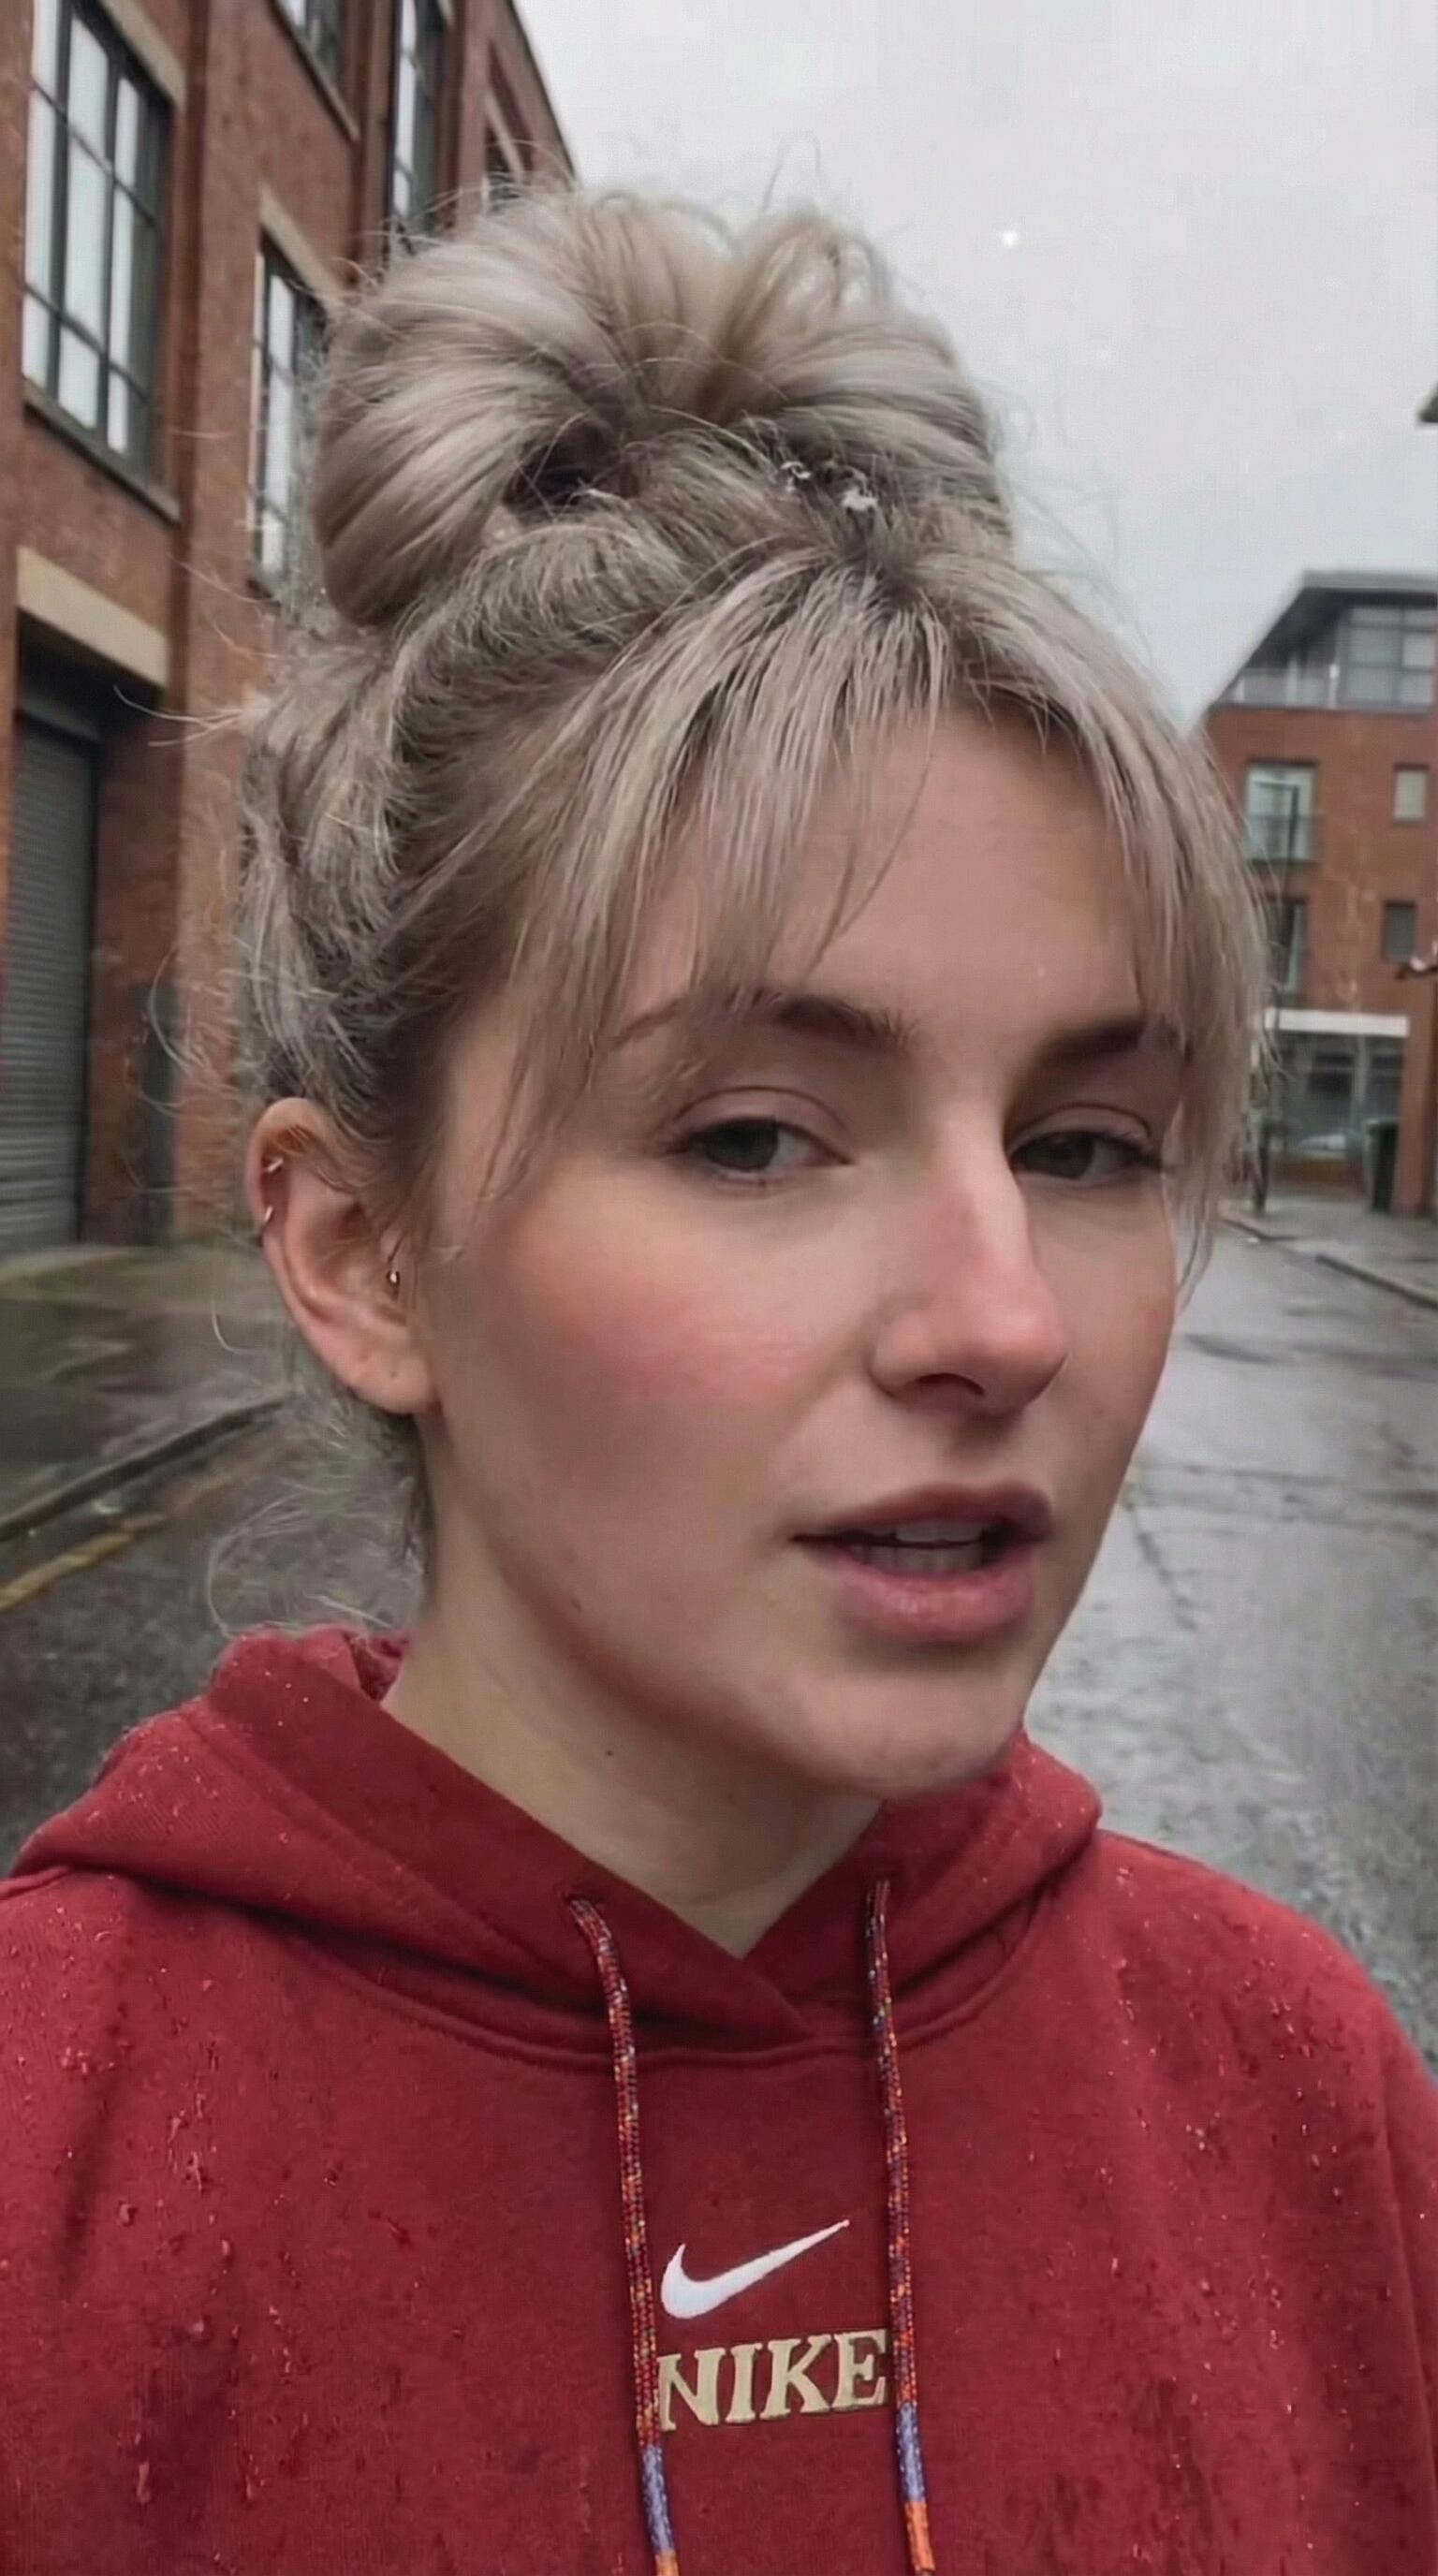
图2(咖啡): 人物手持咖啡,看镜头。
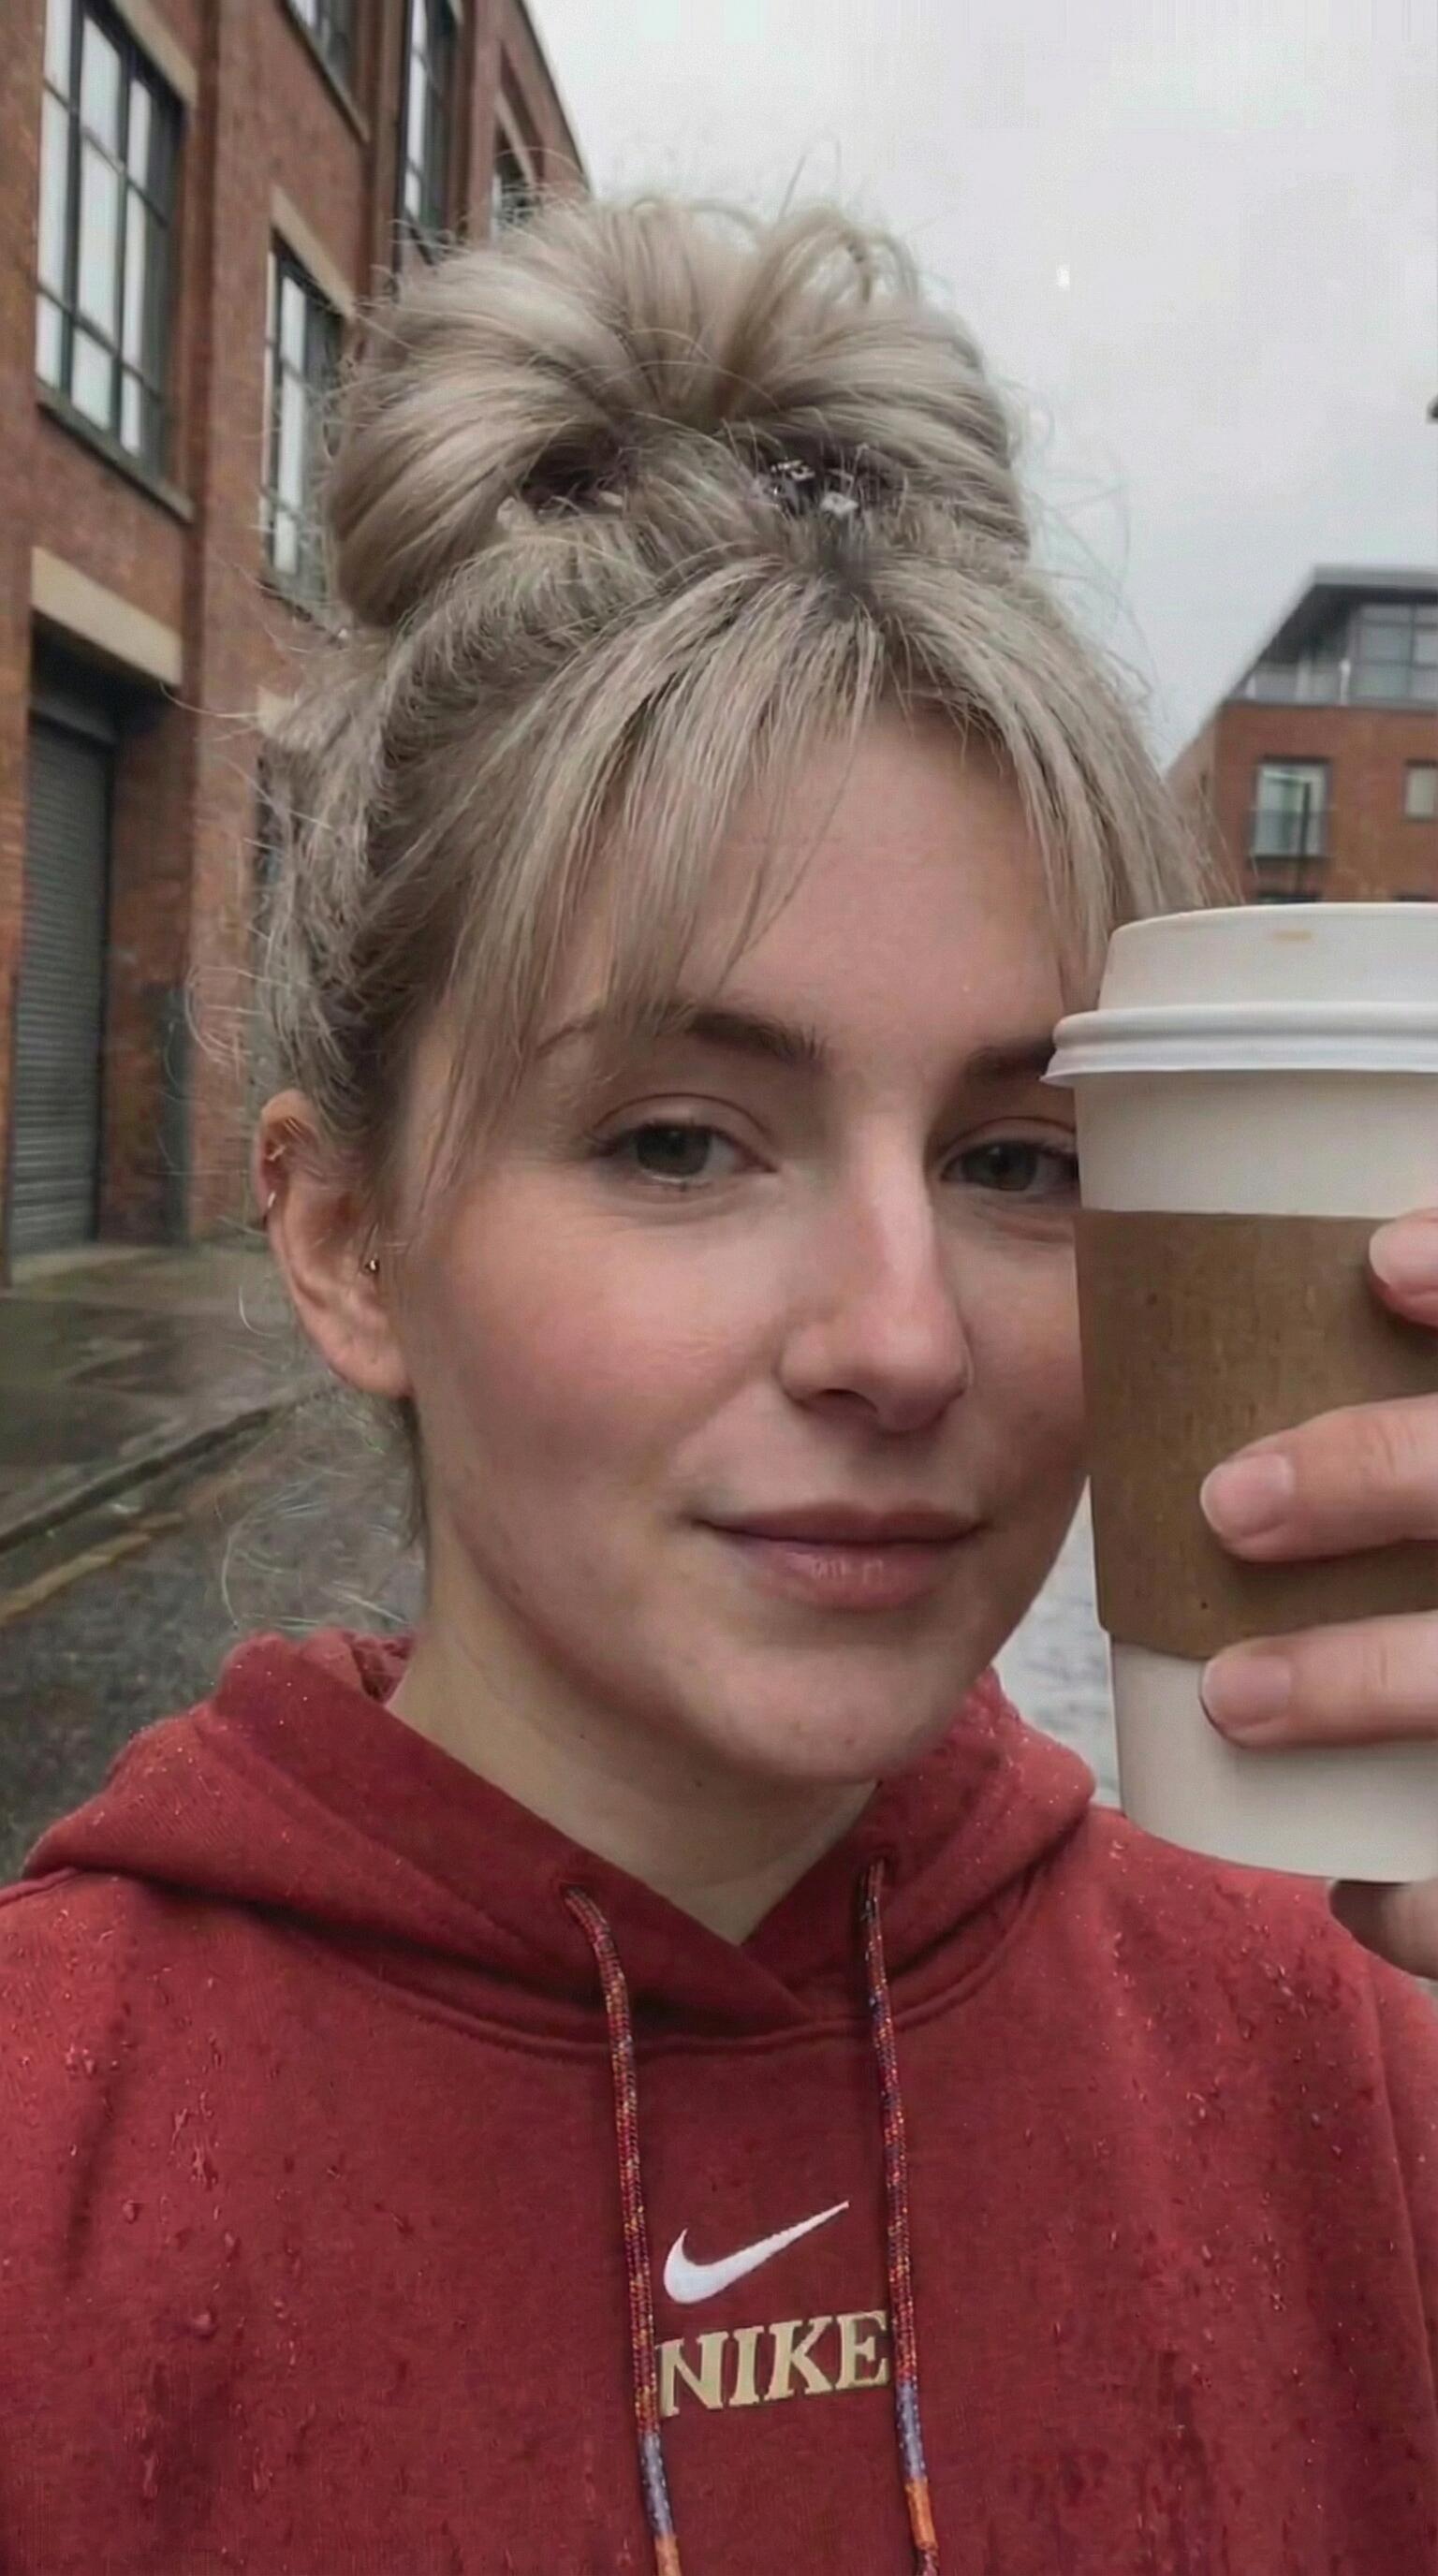
图3(展示): 人物低头看衣服,手指指向 Logo 刺绣。
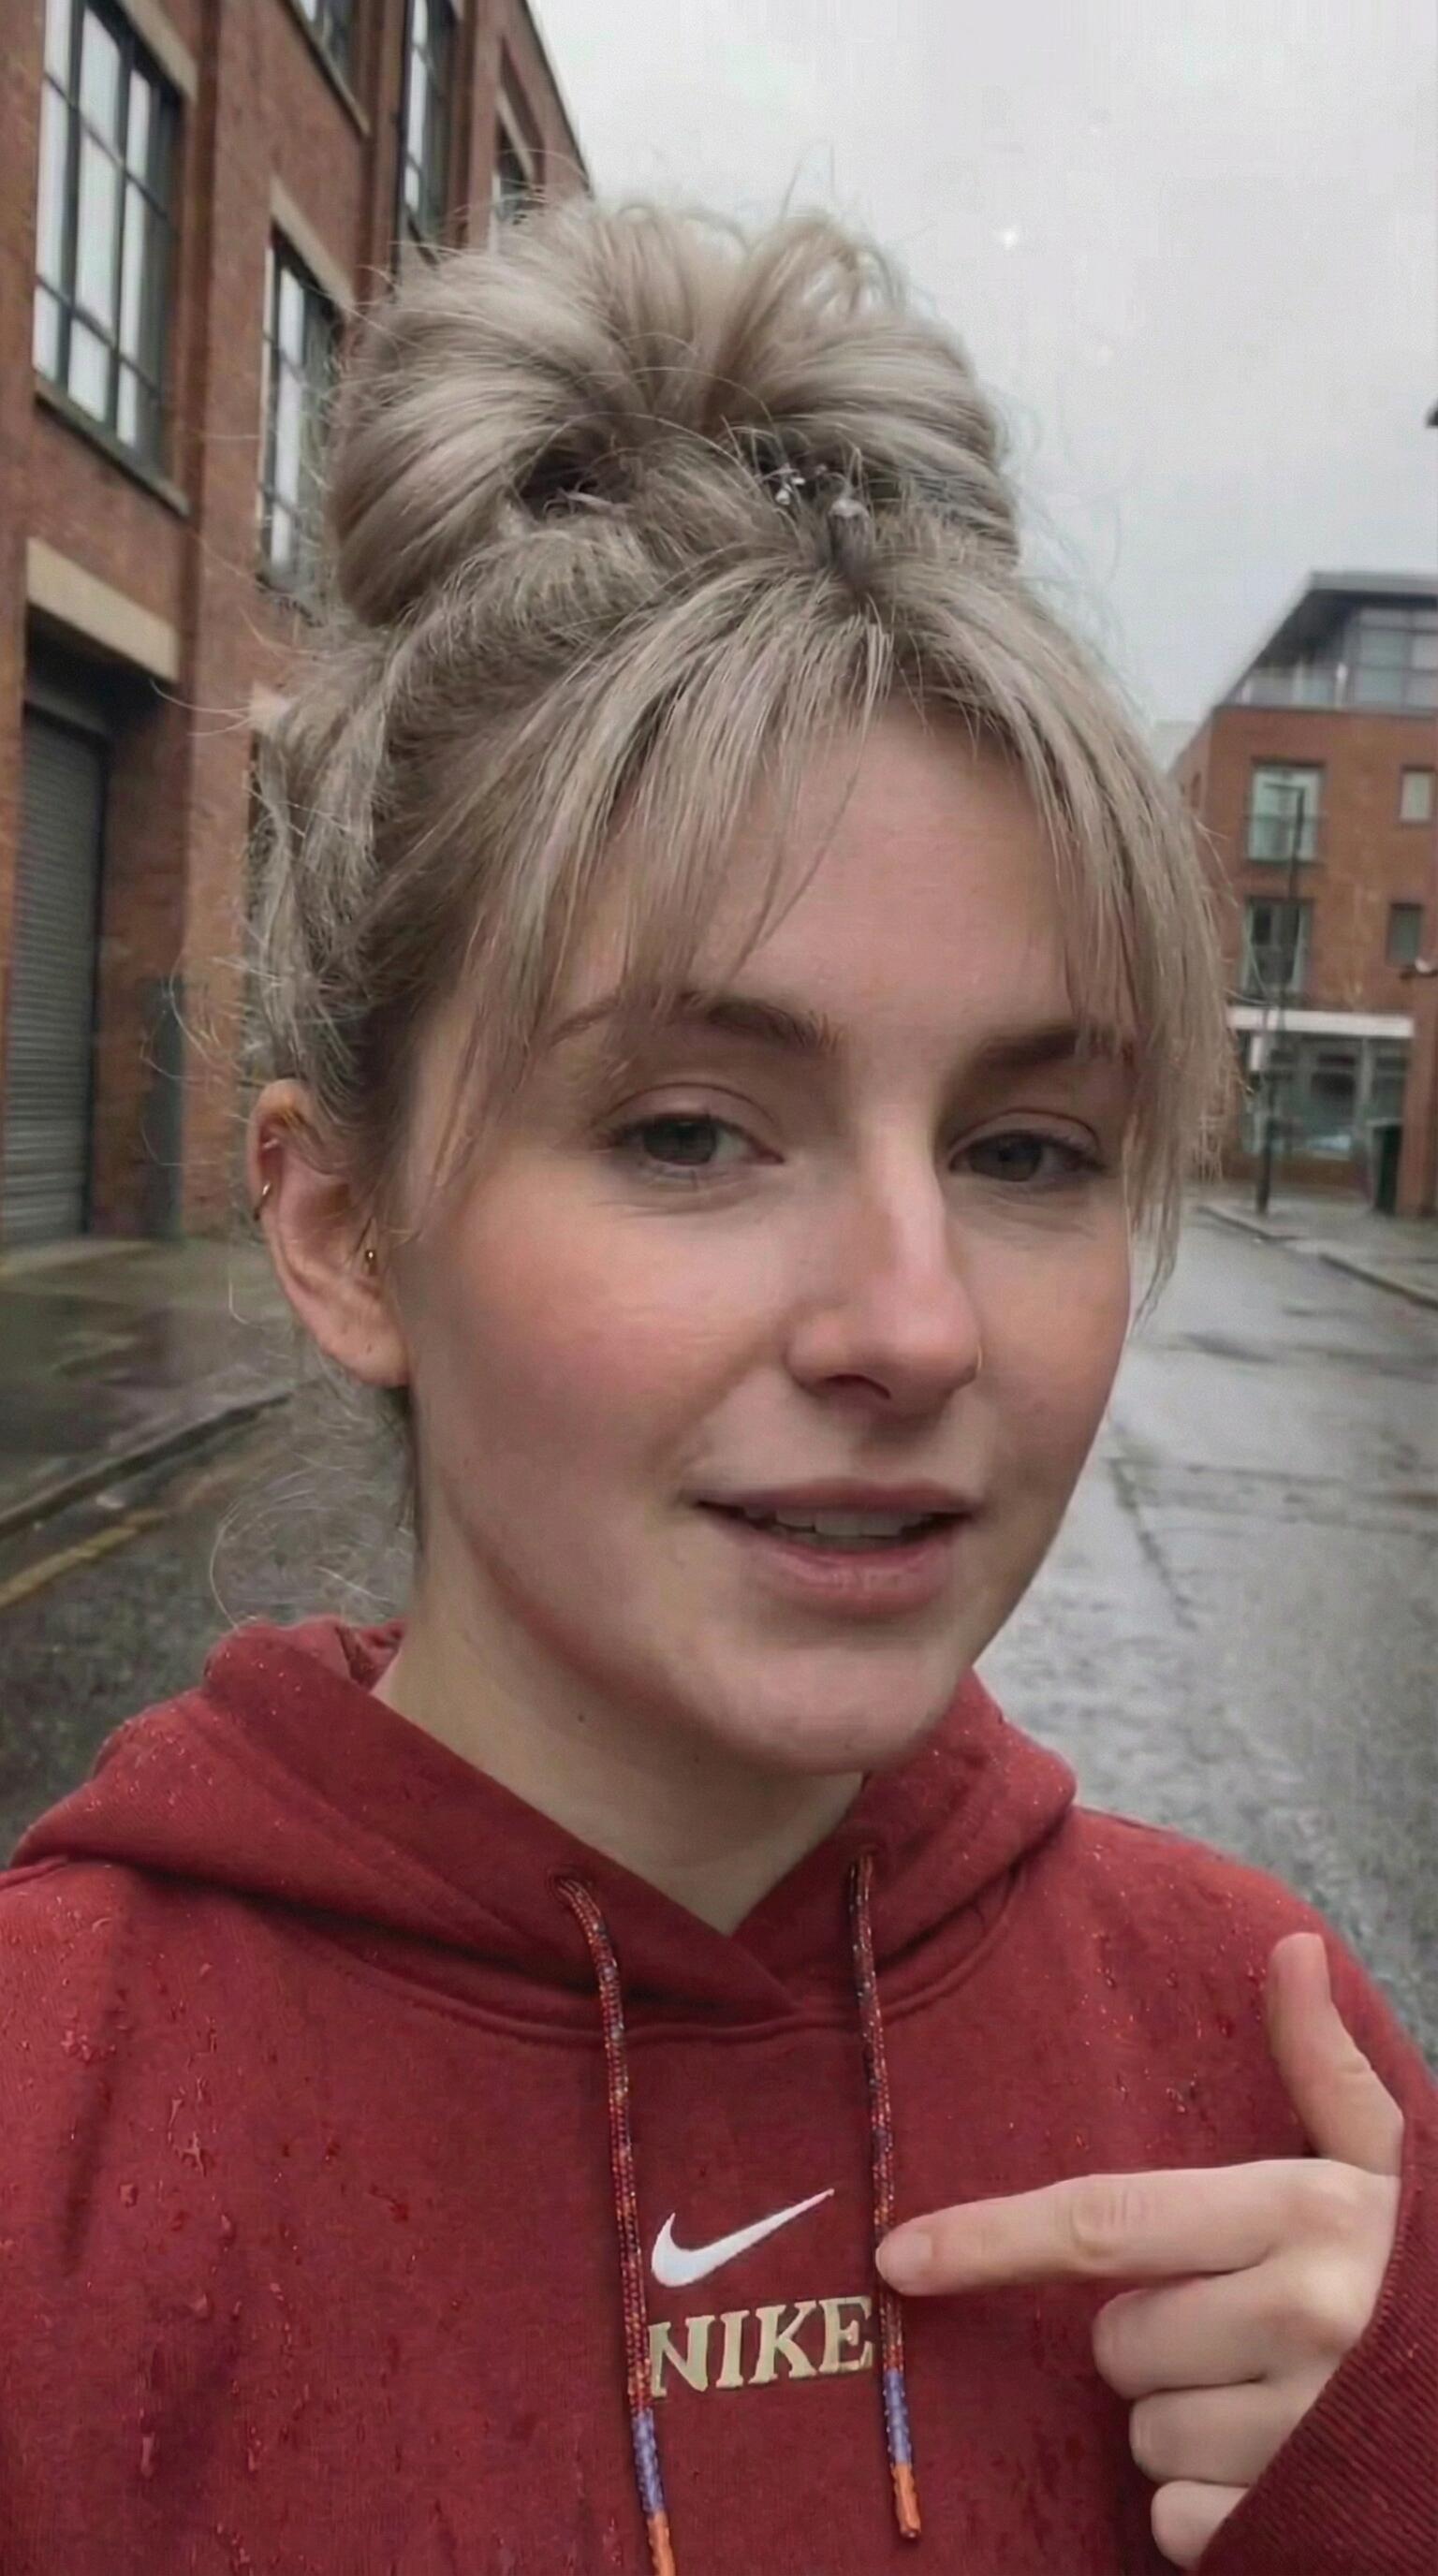
图4(细节): 镜头推近,展示领口和抽绳细节。
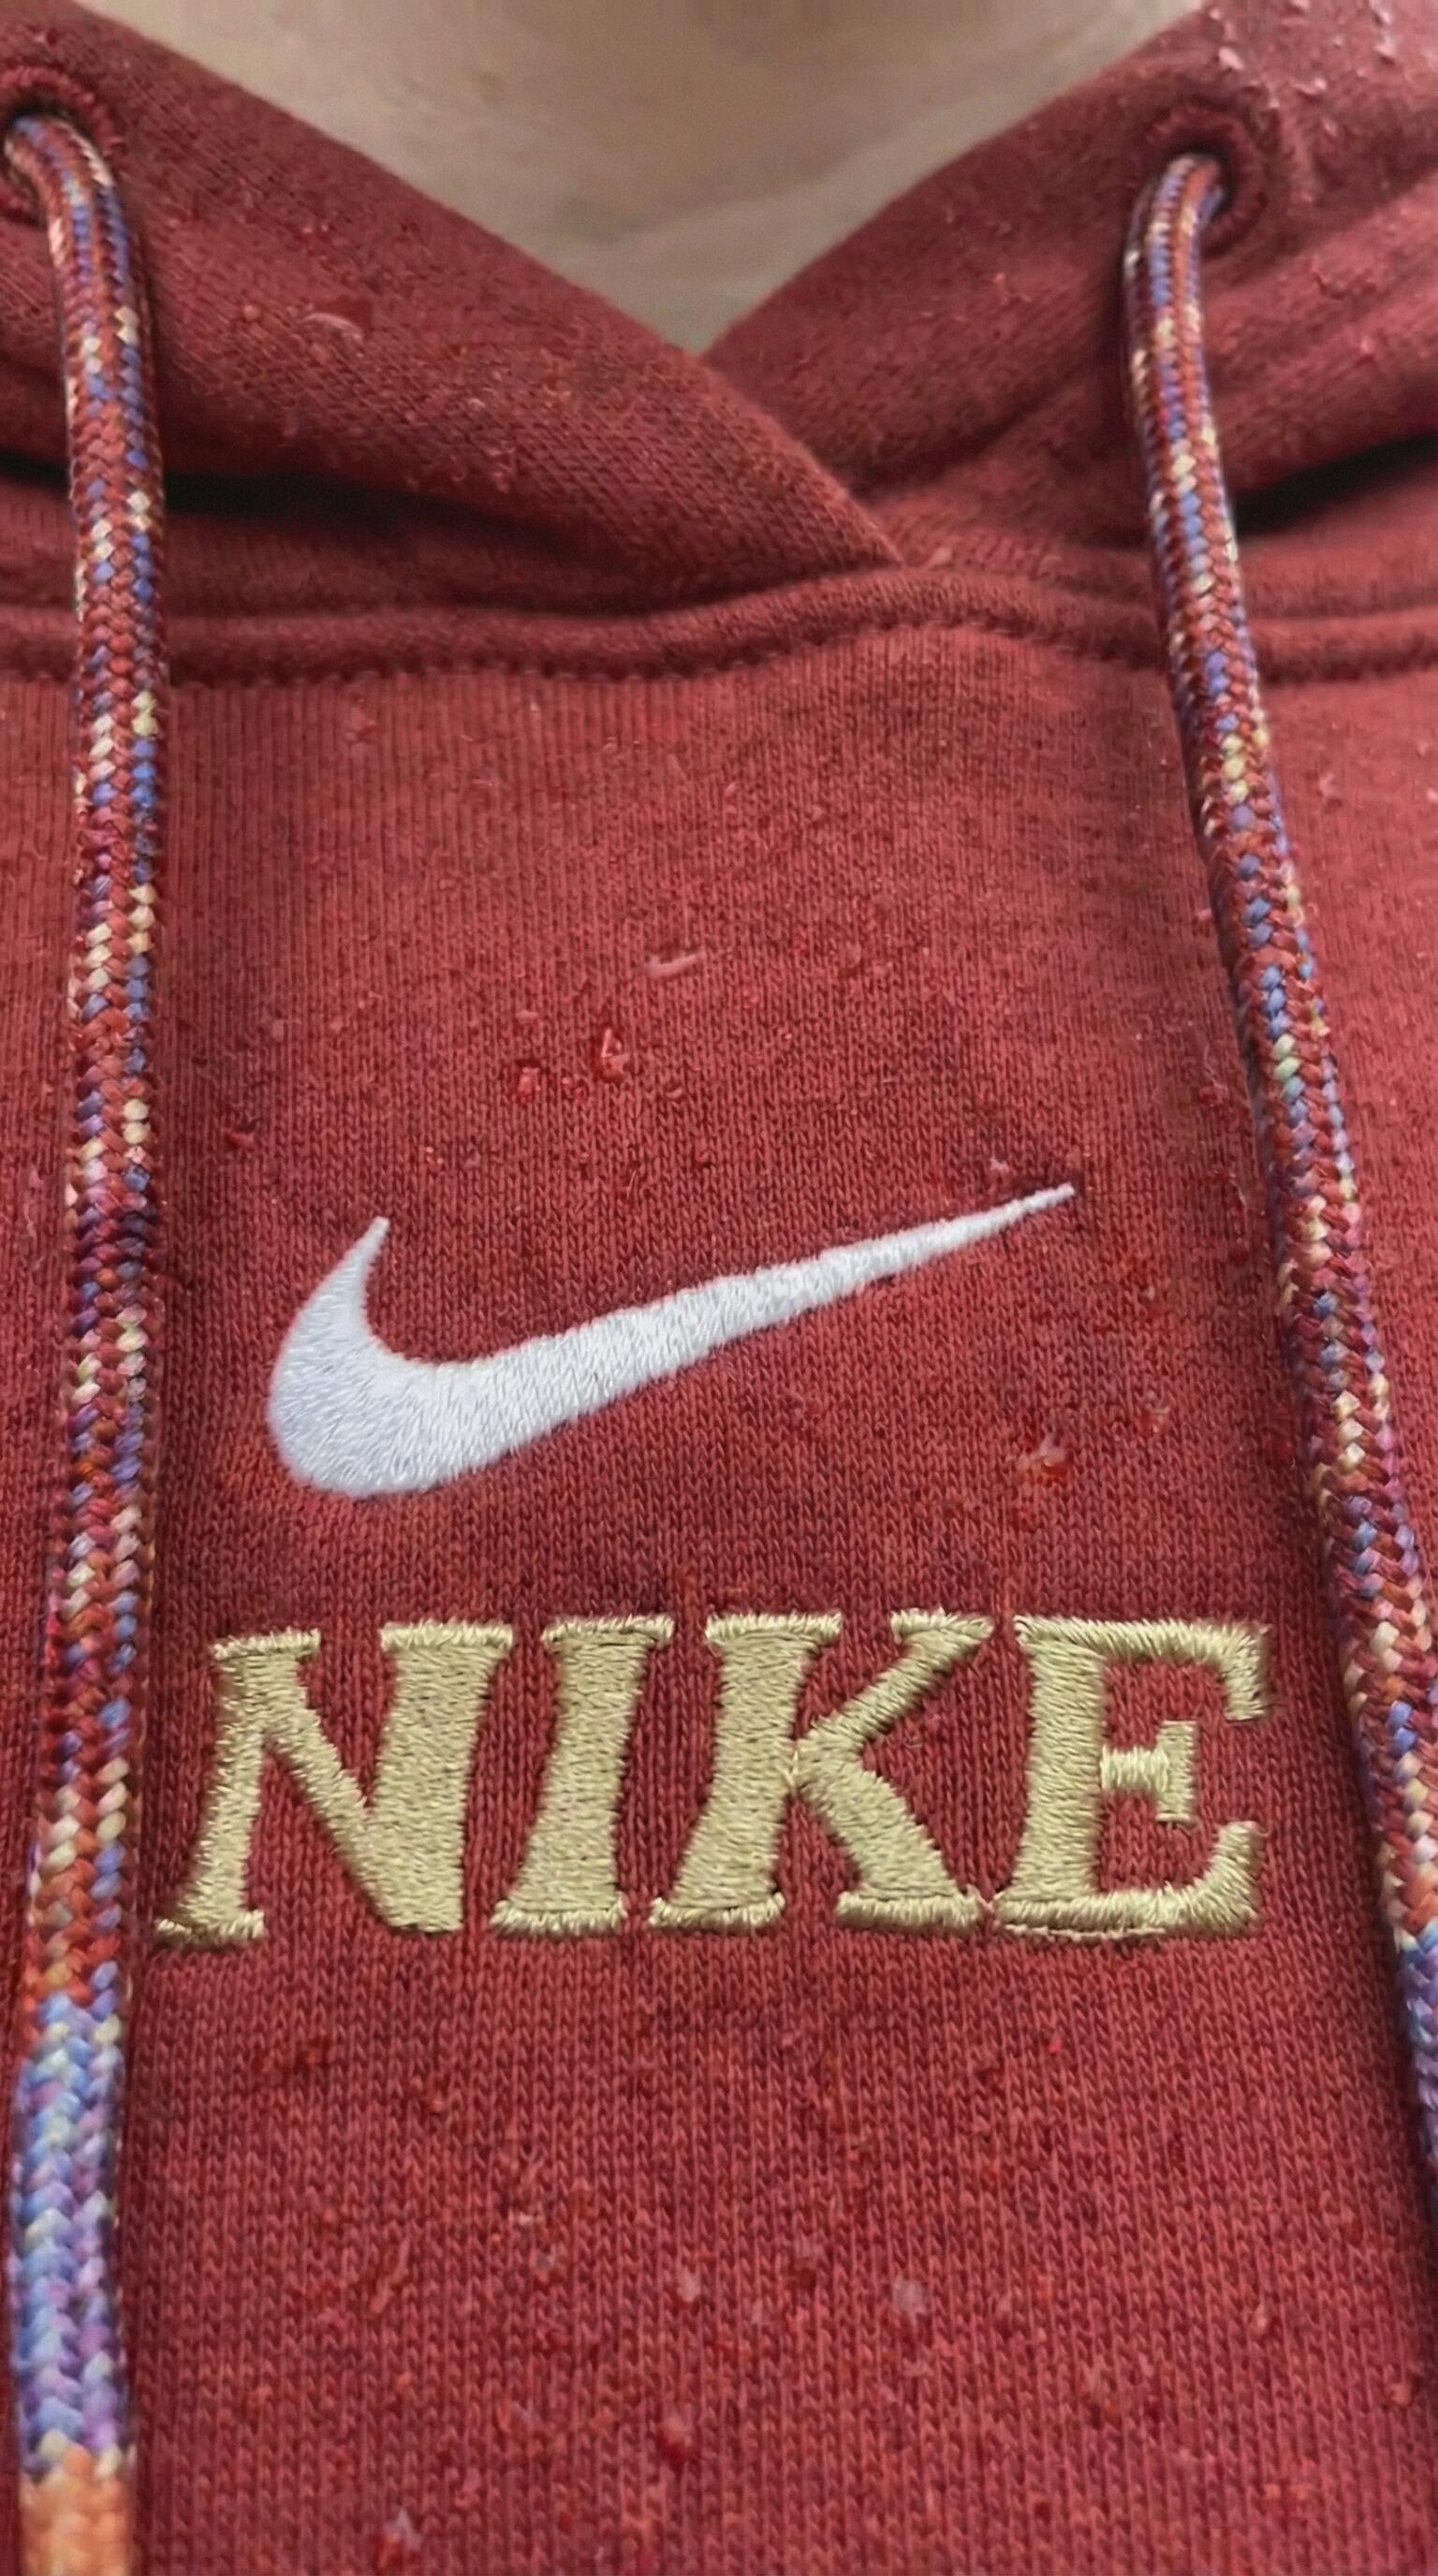
图5(面料): 展示袖口紧实度。
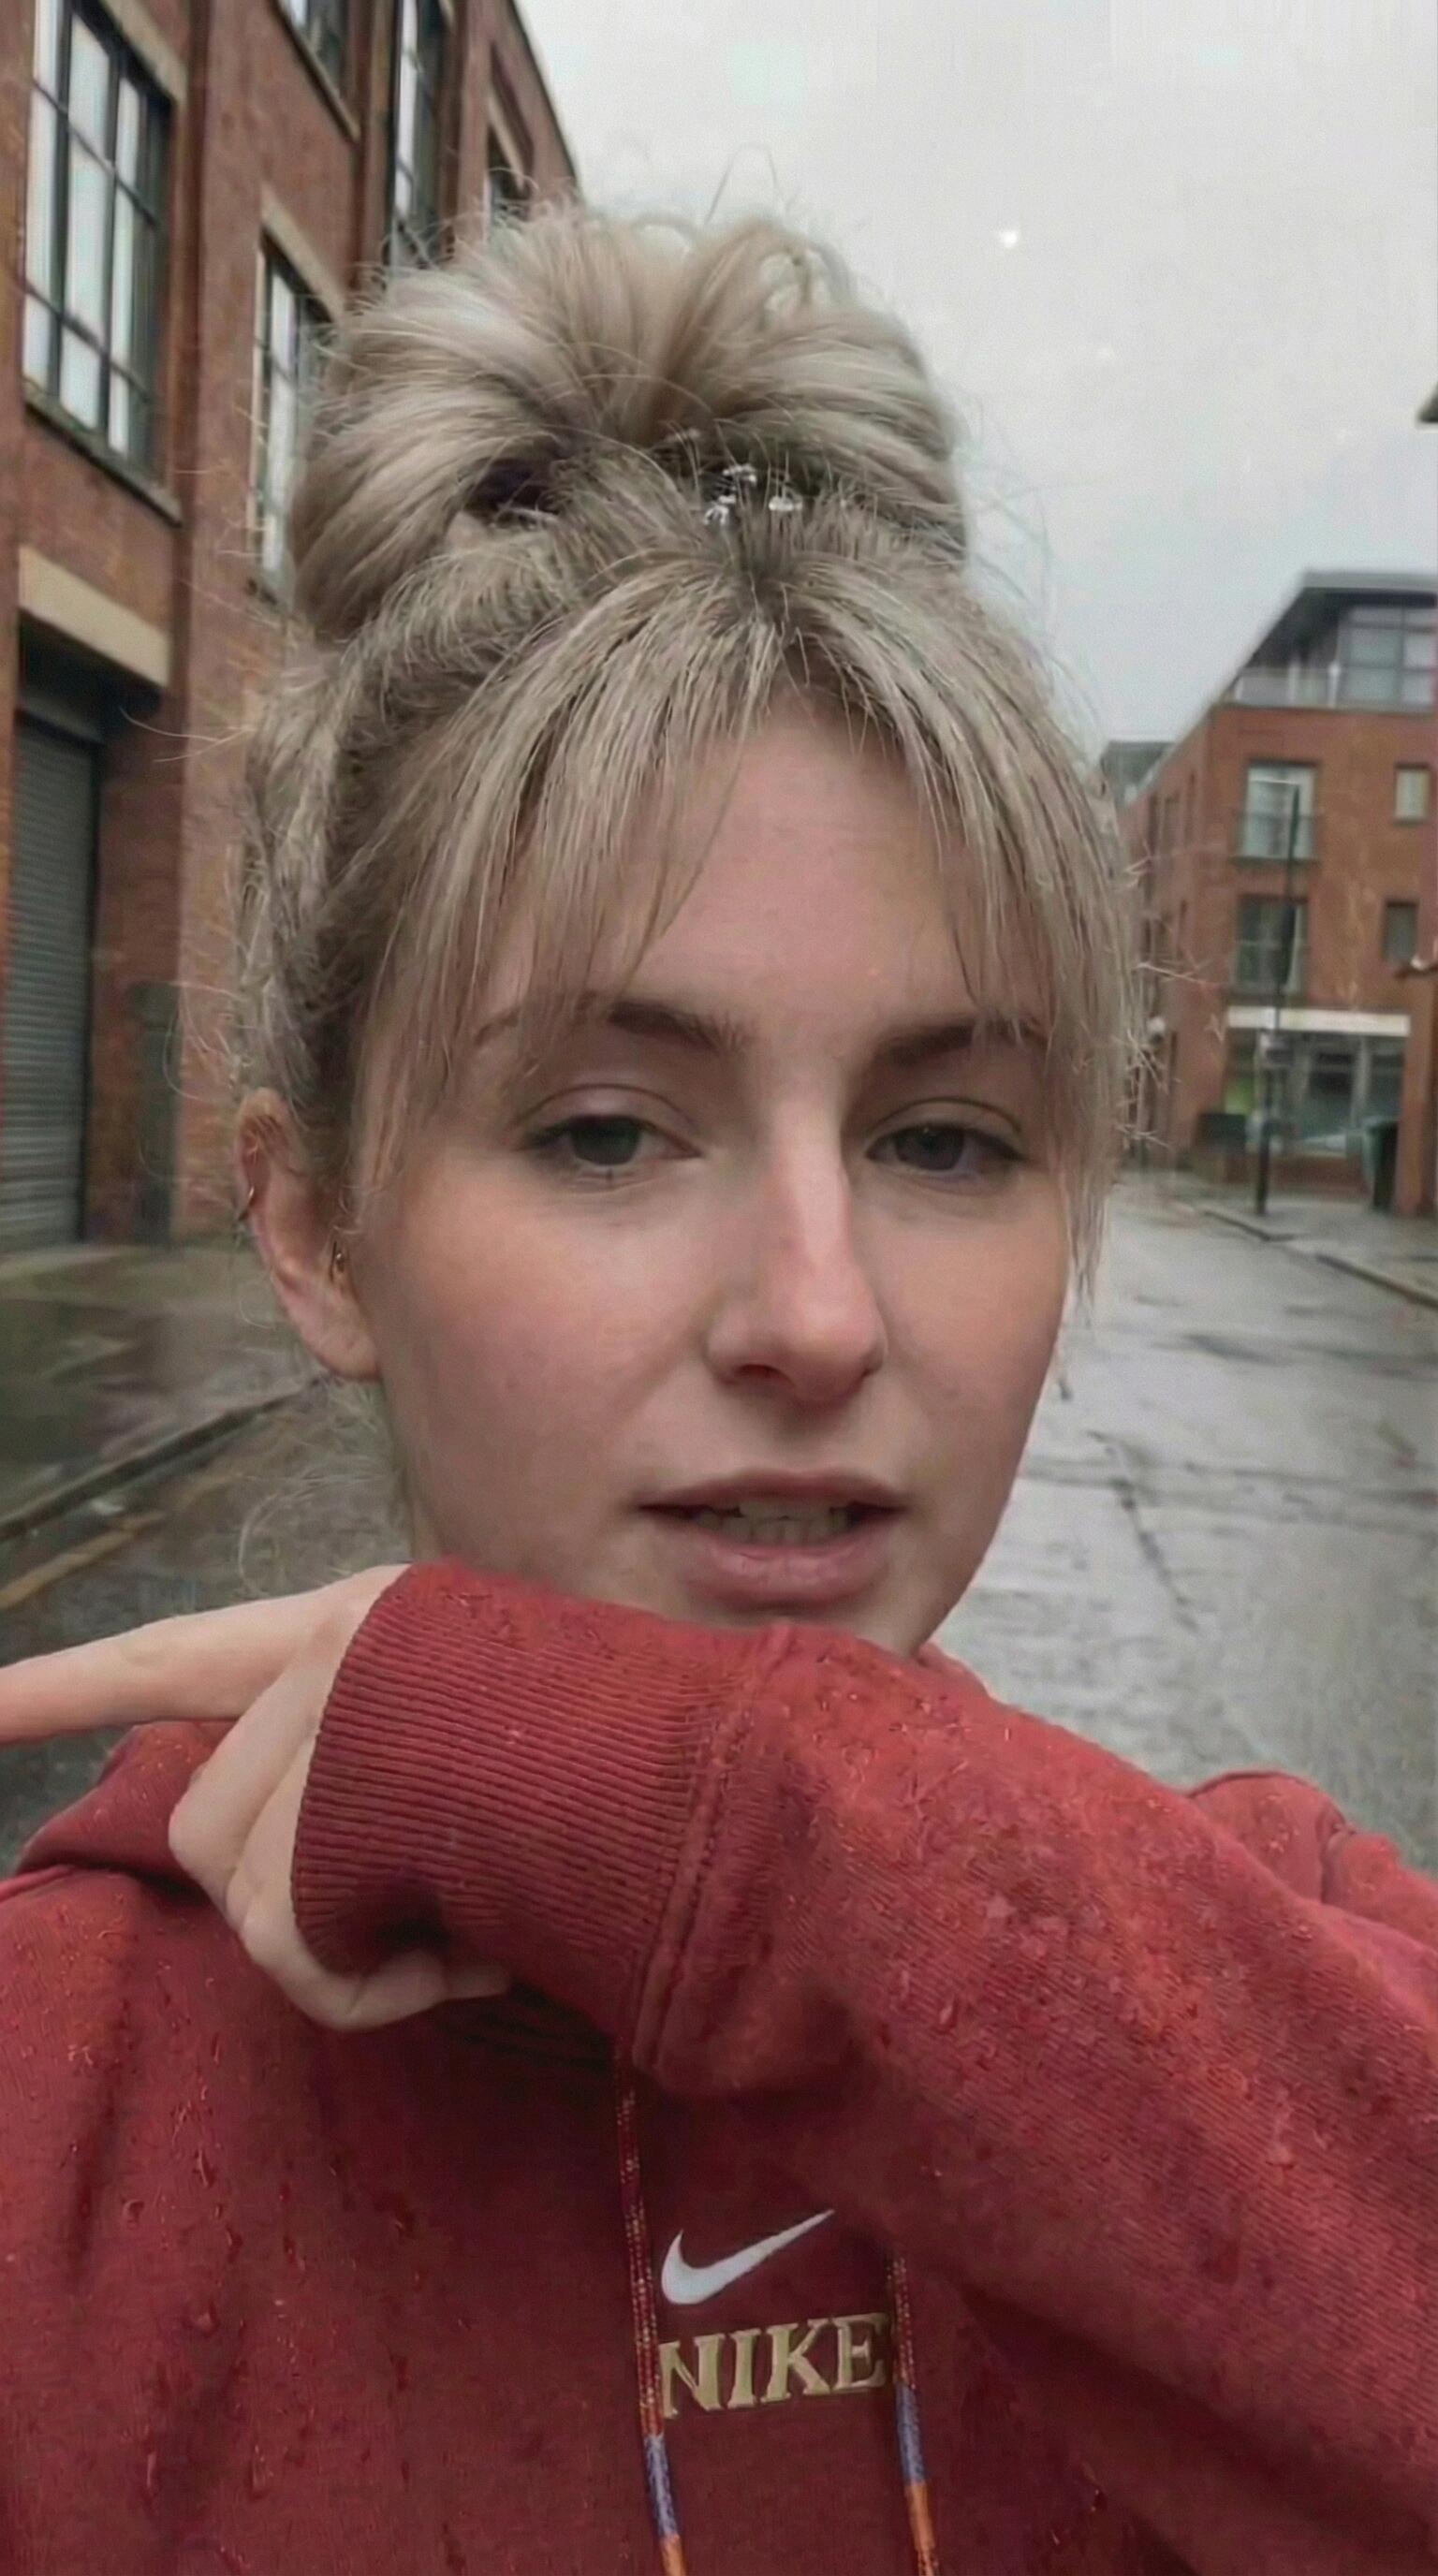
图6(互动): 人物拉起帽子准备戴上。
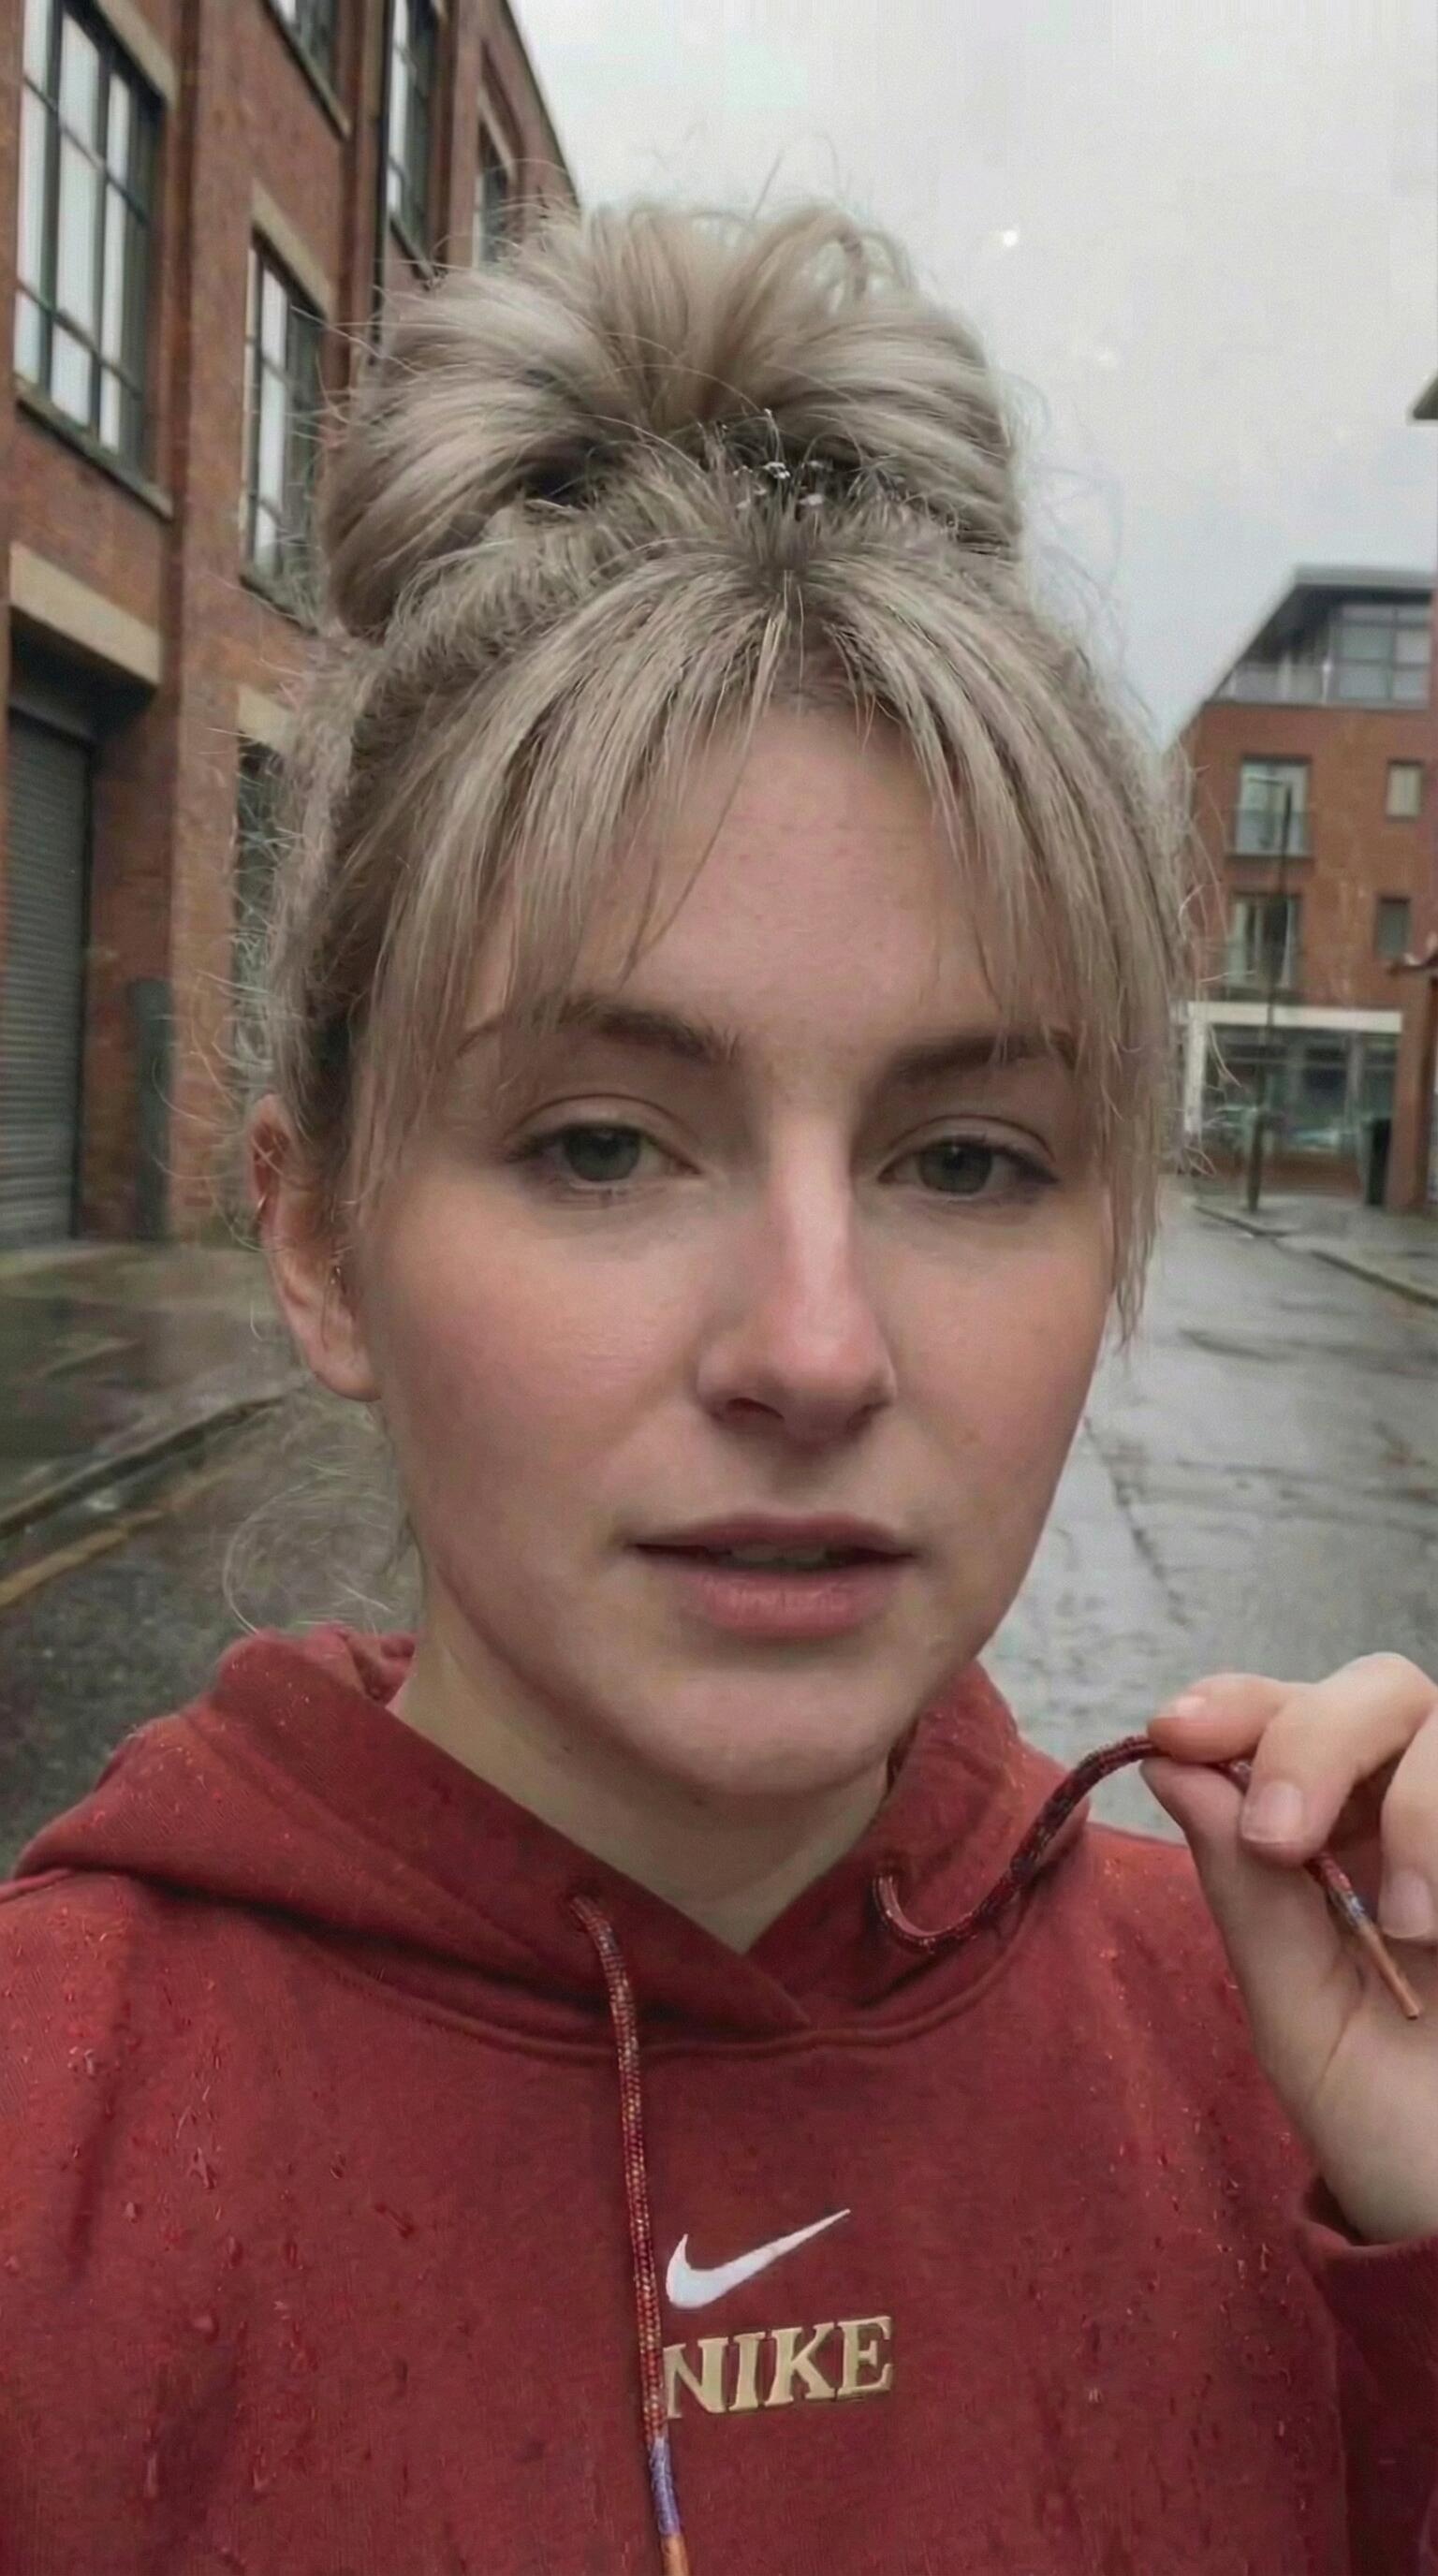
图7(戴帽): 帽子完全戴好,包裹住头部。
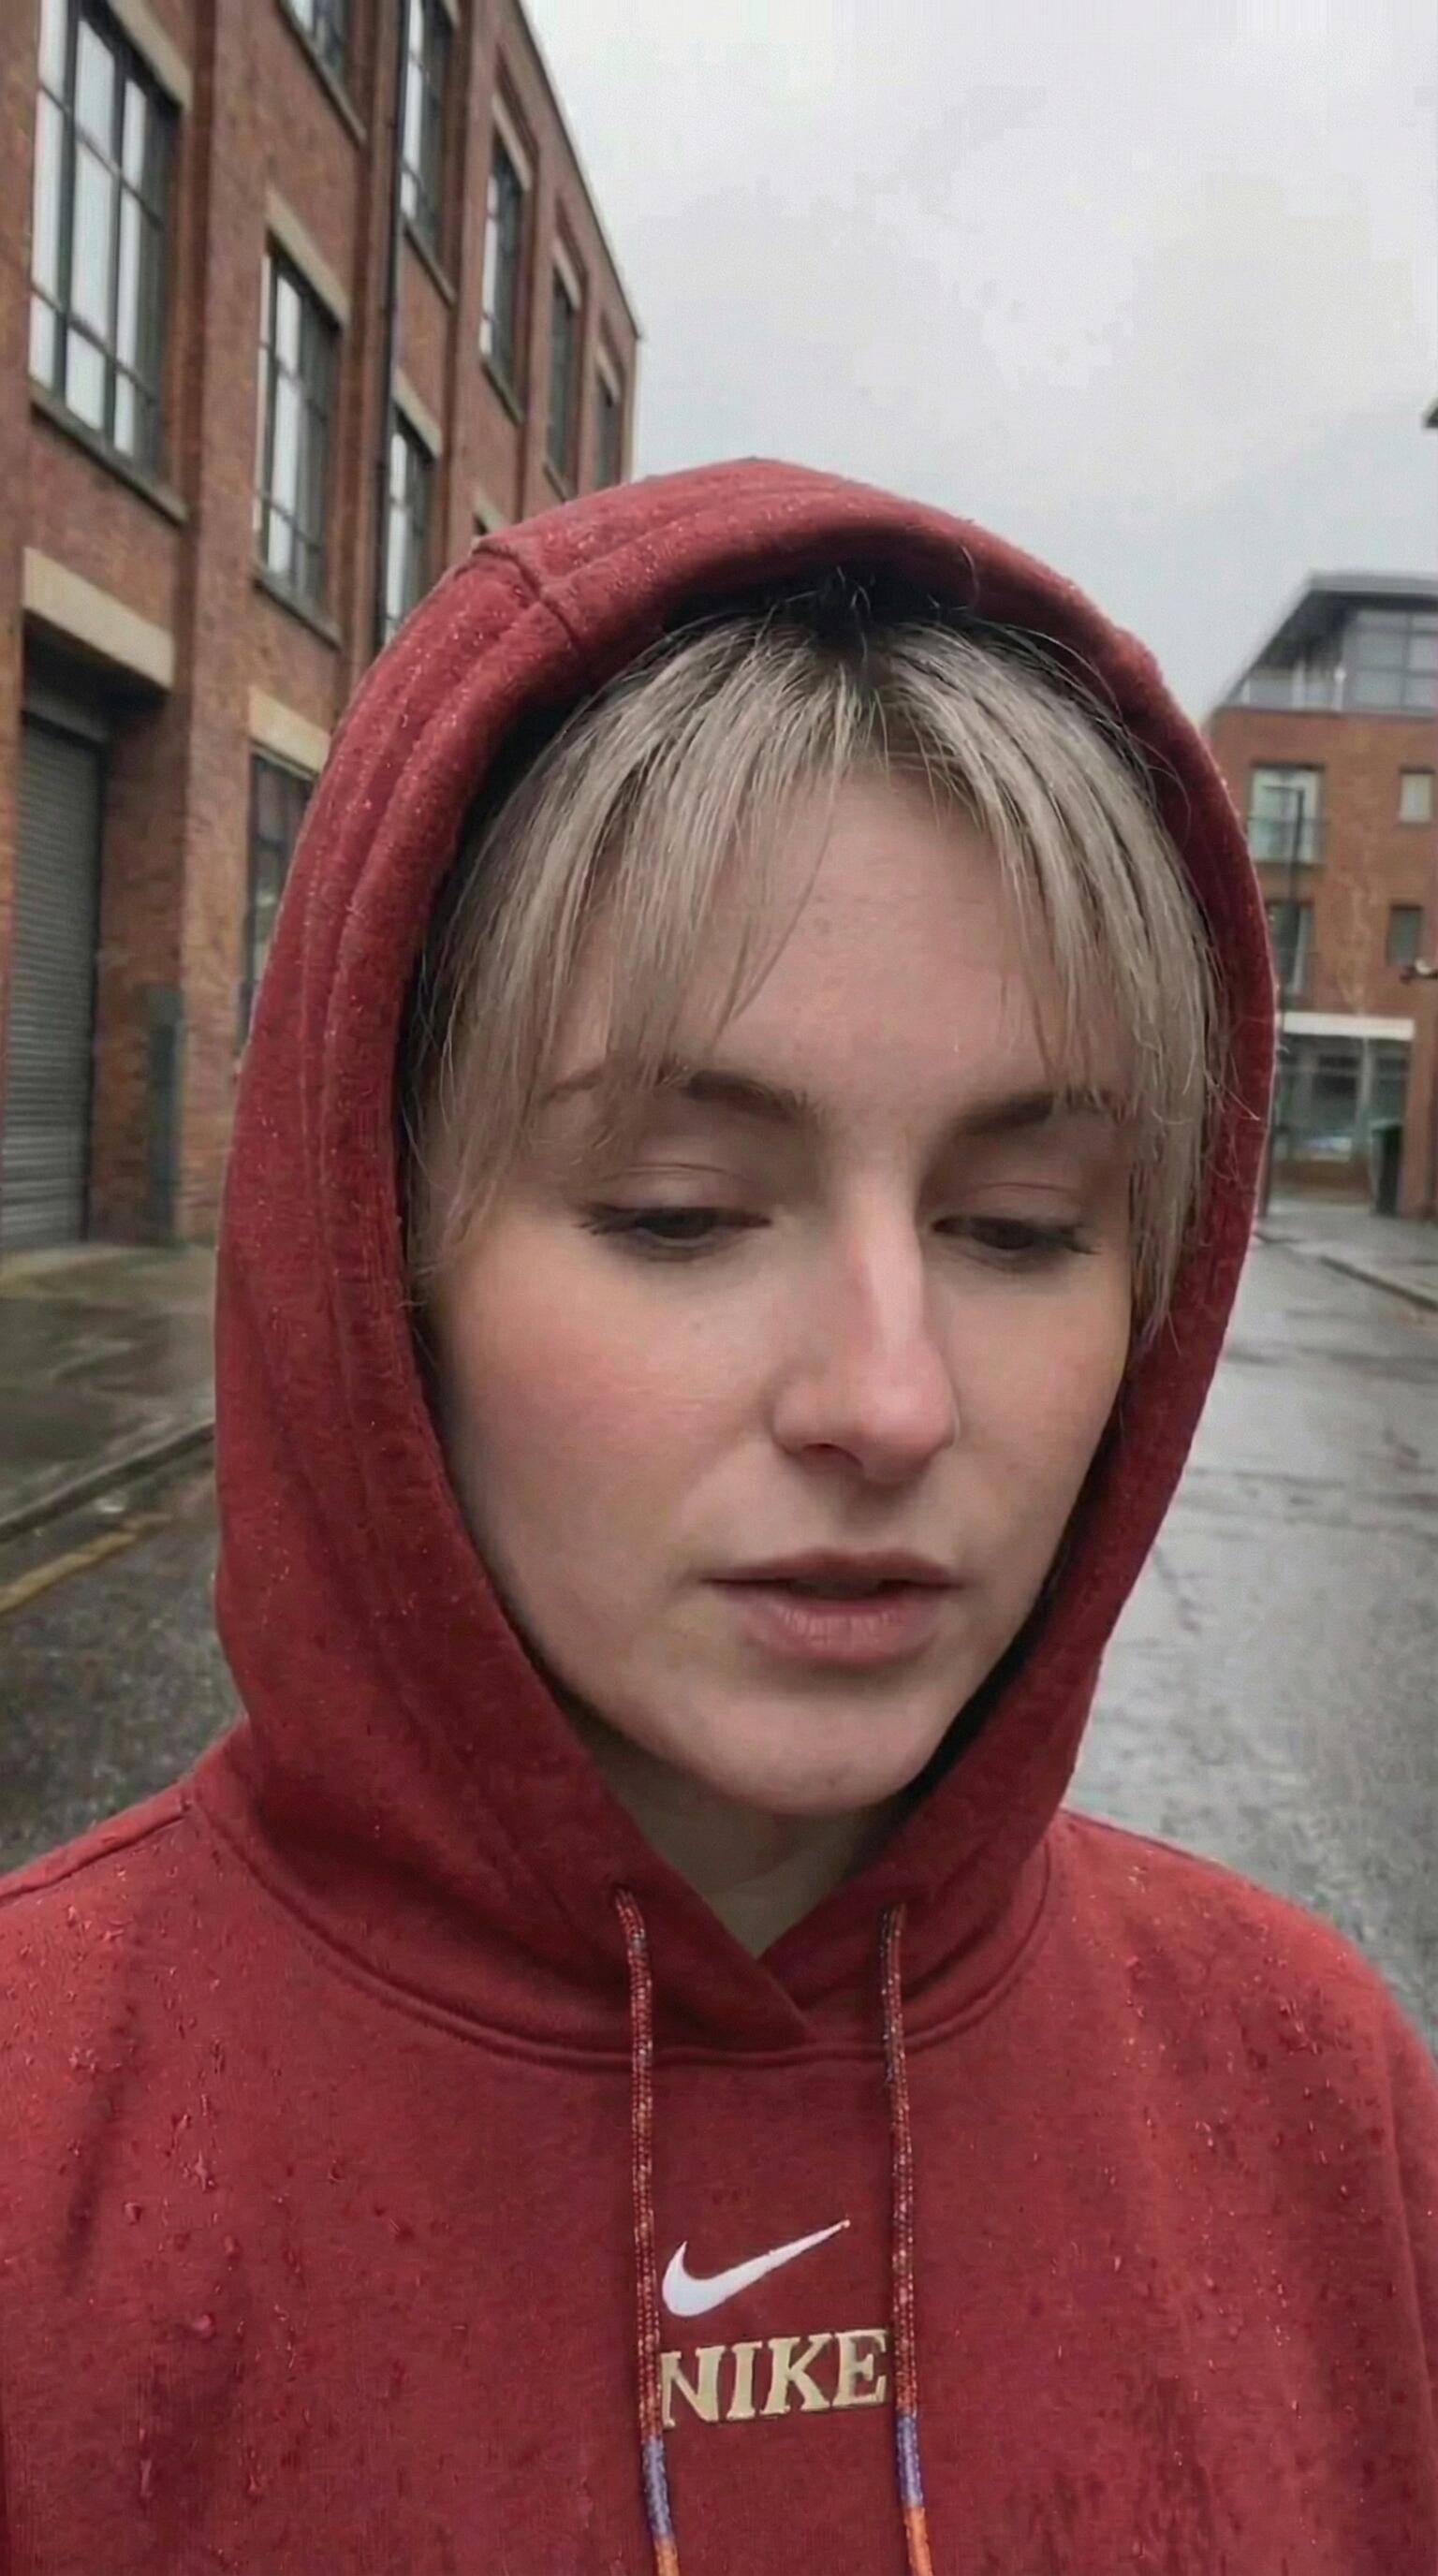
技巧: 每一张图都是基于上一张图进行微调,确保人物长相、环境光影严格一致,只改变动作。
第四步:首尾帧“桥接”生成
有了这一组连续的图片,我们不再盲目生成视频,而是使用“首尾帧”:
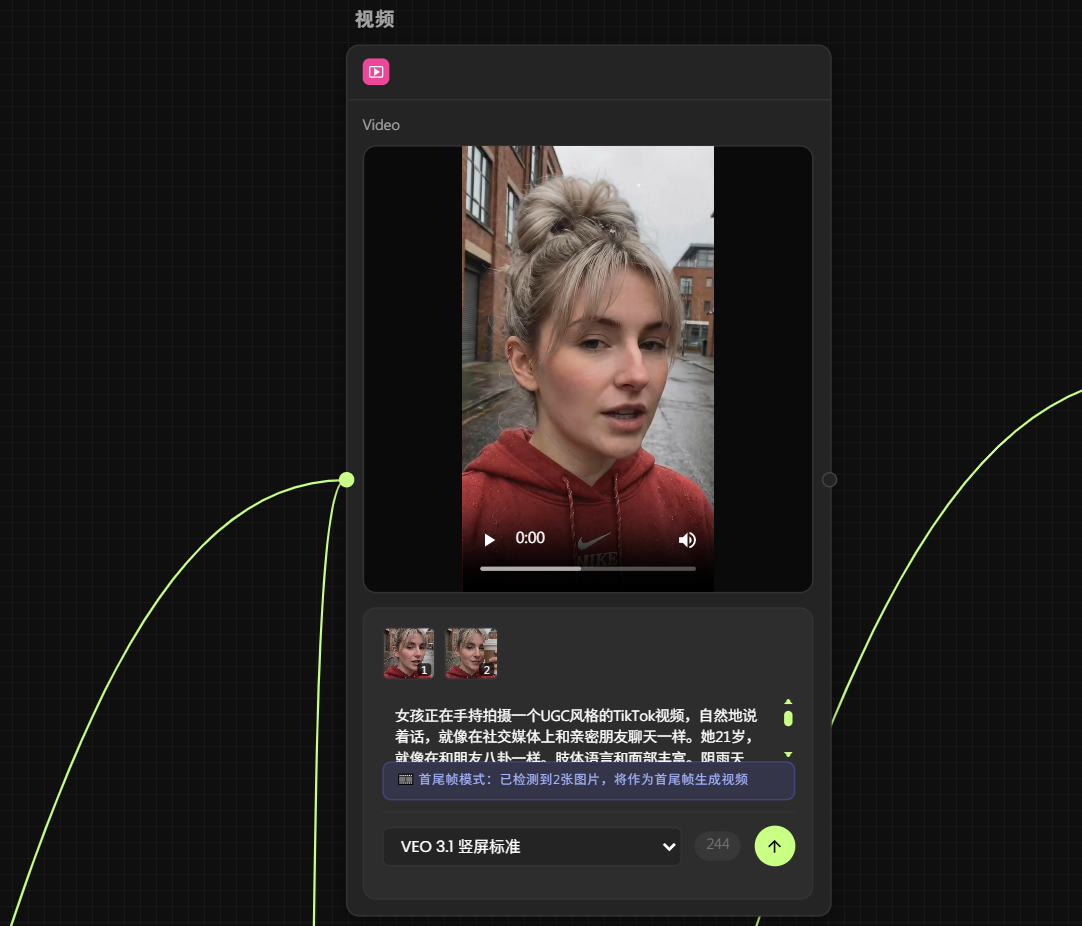
Clip A: 设置 [图1] 为起始帧,[图2] 为结束帧 → 生成视频片段。
Prompt:
女孩正在手持拍摄一个UGC风格的TikTok视频,自然地说着话,就像在社交媒体上和亲密朋友聊天一样。她21岁,就像在和朋友八卦一样。肢体语言和面部丰富。阴雨天气。她说:"Honestly, I didn't expect it to be this cold today. Good thing I grabbed this hoodie before heading out for coffee; it's a lifesaver."说话的同时举起右手的咖啡
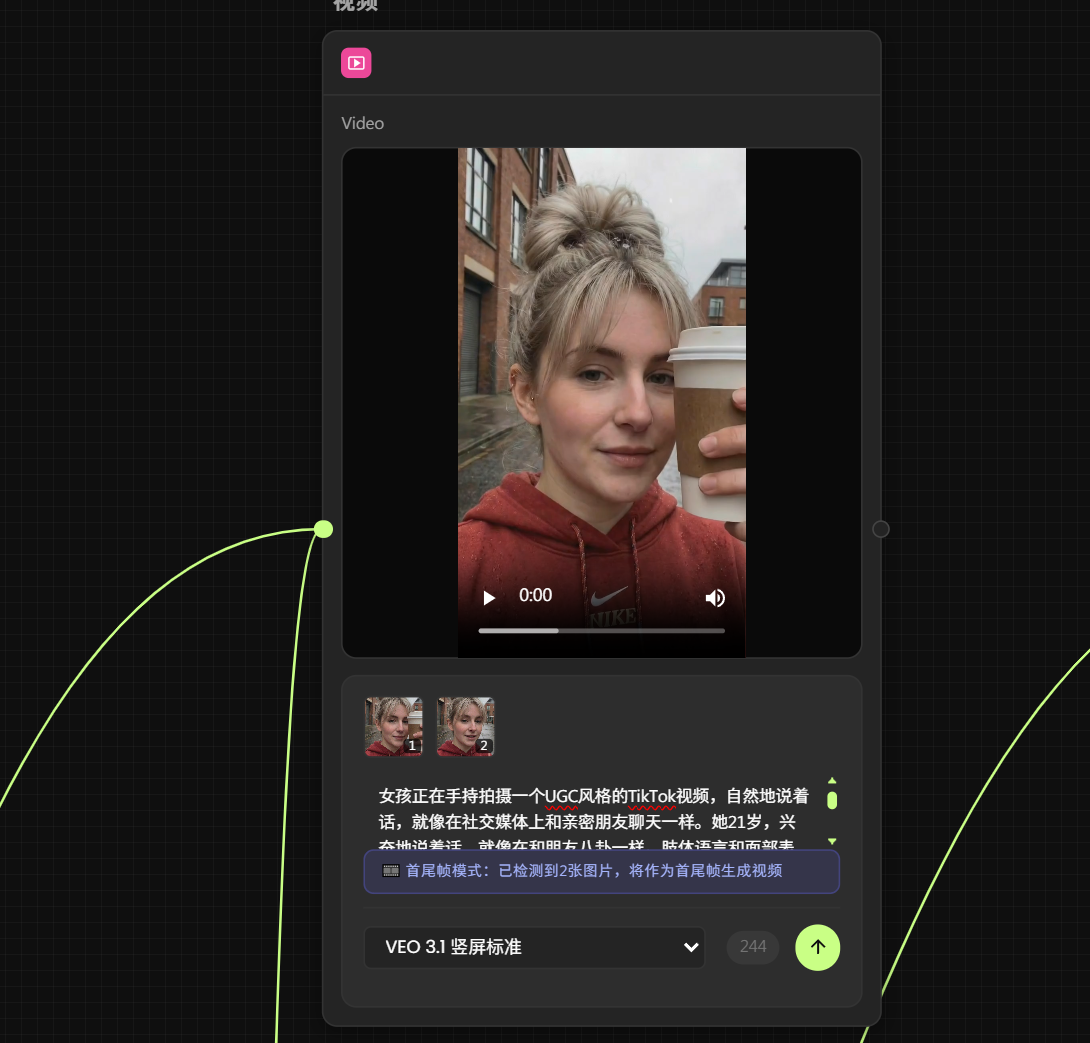
Clip B: 设置 [图2] 为起始帧,[图3] 为结束帧 → 生成视频片段。
Prompt:
女孩正在手持拍摄一个UGC风格的TikTok视频,自然地说着话,就像在社交媒体上和亲密朋友聊天一样。她21岁,兴奋地说着话,就像在和朋友八卦一样。肢体语言和面部表情非常丰富。阴雨天气。她说:"It feels surprisingly thick. You know that heavy, cozy feeling that makes you feel secure? It’s got that."说话的同时她把咖啡放下,手指领口的logo
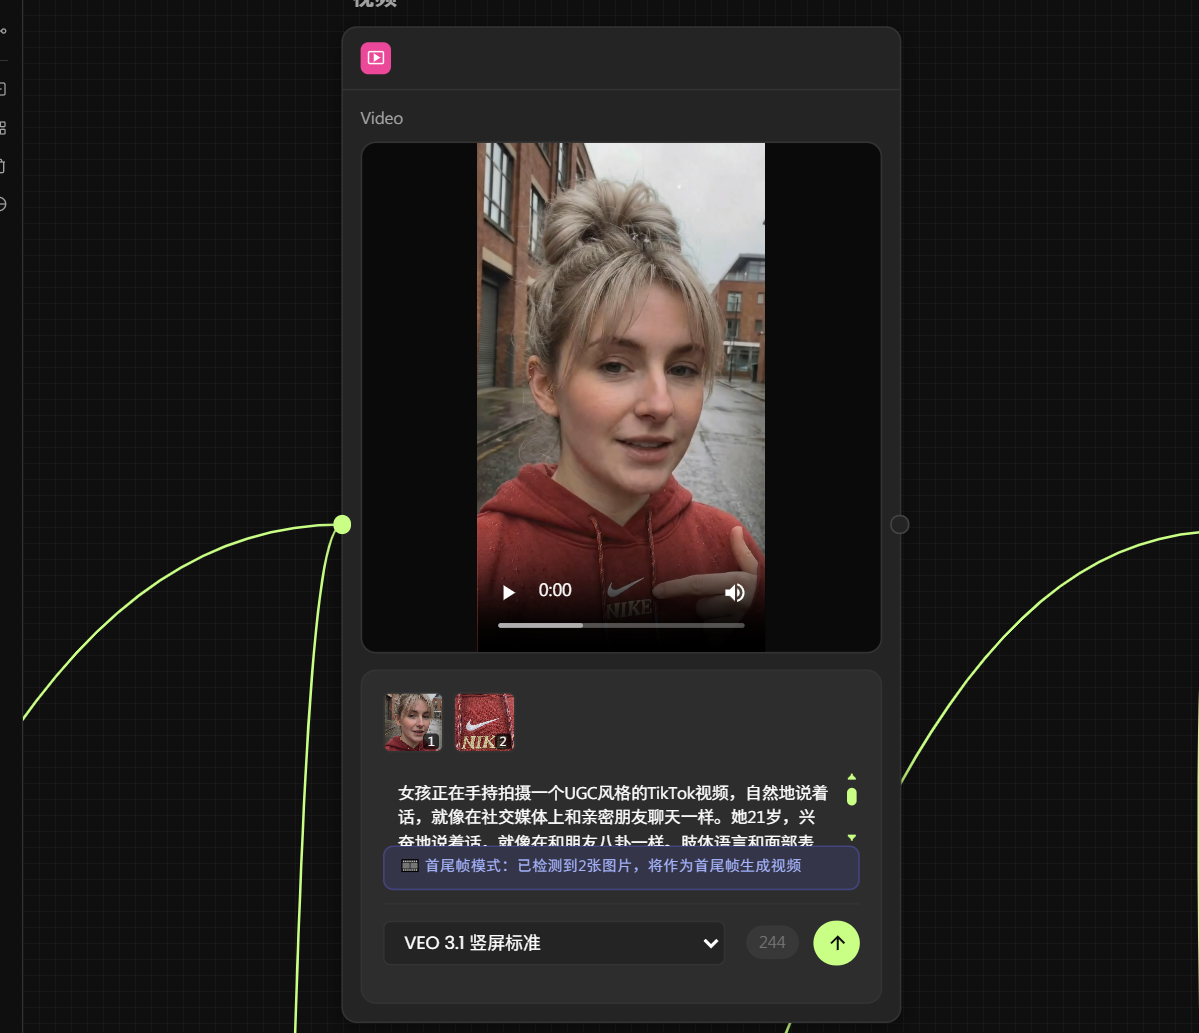
Clip C: 设置 [图3] 为起始帧,[图4] 为结束帧 → 生成视频片段。
Prompt
女孩正在手持拍摄一个UGC风格的TikTok视频,自然地说着话,就像在社交媒体上和亲密朋友聊天一样。她21岁,兴奋地说着话,就像在和朋友八卦一样。肢体语言和面部表情非常丰富。阴雨天气。她说:" I actually really like the embroidery here. And look at these colorful strings—a bit retro without being too much."说话的同时她镜头对准自己的领口logo,画面中间虚焦了一下
循环操作: 依次完成所有片段的生成。
这种方法完美解决了 AI 视频容易“崩坏”和“甚至变形”的问题,牢牢锁住了人物的一致性。
第五步:剪辑与合成
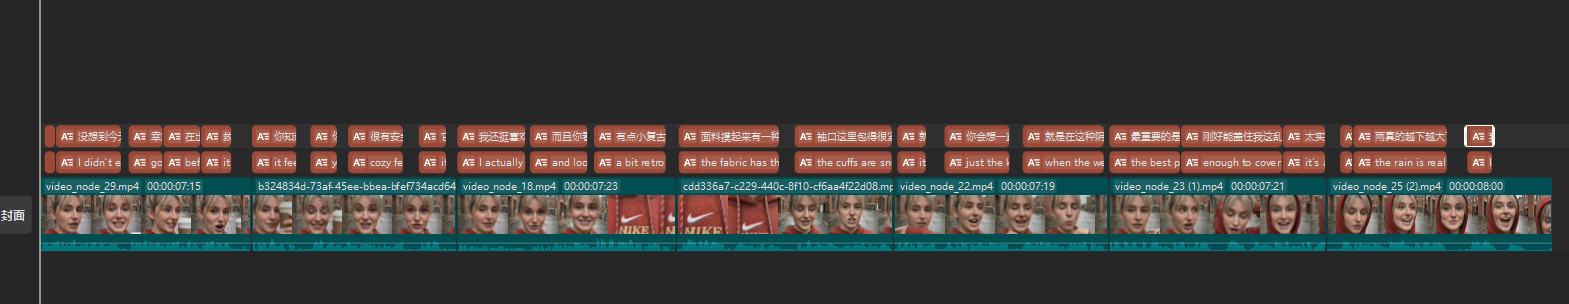
将生成的 Clip A, B, C... 按顺序导入轨道。
由于我们是首尾相连生成的,视频片段之间的衔接会非常丝滑,几乎看不出剪辑痕迹,形成“一镜到底”的视觉错觉。
只需要简单拼接即可。
加上字幕后导出视频
【免责声明】 本课程内容仅为AIGC技术教学与案例分析之目的,所引用的品牌名称、商标、Logo、广告素材等均属各自权利人所有。本平台与所提及的任何品牌方不存在任何形式的合作、联名、代言或授权关系。课程内容仅供学习参考,不构成任何商业建议。如权利人认为内容涉及侵权,请联系我们(联系方式 WX:Xiaofengguwen010),我们将在核实后第一时间处理。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「不仅是换装:教你用 AI 生成连贯、真实的口播视频」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「准备工具」,再把「第一步:构建人物“灵魂”」定住,接着处理「第二步:产品植入与换装」;最后用「第三步:绘制关键帧脚本」收口。
- 先把「准备工具」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「第二步:产品植入与换装」后,先查连贯性和穿帮。
- 先把「第三步:绘制关键帧脚本」里的主体和动作定死。
- 做完「第五步:剪辑与合成」后,先查连贯性和穿帮。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「不仅是换装:教你用 AI 生成连贯、真实的口播视频」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。